Carnet, support de cours
Architecture logicielle
Ce cours présente les couches d’une application, les stratégies de rendu et les critères pour justifier un choix technique.
Sommaire
- Comprendre une stack techniqueDécrire le périmètre, Stack et architecture répondent à des questions différentes, Exemples de stacks, Deux autres exemples, Documenter la stack d’un projet
- Frontend, backend et renduFrontend, Backend, CSR : rendu côté client, SSR : rendu côté serveur, SSG : génération statique, Hydratation, SPA : navigation sans rechargement complet, Rendu hybride, Exemples de frameworks et d’outils, Avantages et limites, Questions de décision
- Patterns, styles et abstractionsOrganisation interne d’une application, MVC (Modèle, Vue, Contrôleur), Style d’interface, Accès aux données
- Critères d’un choix techniqueLes critères les plus communs, Critères de contexte et de valeurs, Éliminer les options incompatibles puis comparer, Évaluer aussi le coût des critères de valeur
- Faire des choix techniquesContraintes, critères, hypothèses et preuves, Une préférence peut devenir une décision, Documenter les raisons
- ADRDocumenter les décisions techniques, Format d’un ADR, Version minimale, Règles de rédaction et de suivi
- Exercice : justifier ses choixÀ produire, 1. Délimiter le système, 2. Inventorier les choix existants, 3. Classer les arguments, 4. Écrire un scénario de qualité, 5. Comparer les options, 6. Rédiger deux ADR, 7. Relire avec une autre personne
Architecture logicielle
Ce cours présente les couches d’une application, les stratégies de rendu et les critères pour justifier un choix technique.
Comprendre une stack technique
Une stack technique est l’ensemble des briques technologiques utilisées pour construire, exécuter et livrer une application. Chaque technologie remplit un rôle dans une couche du système, par exemple l’interface, le backend, les données ou l’hébergement.
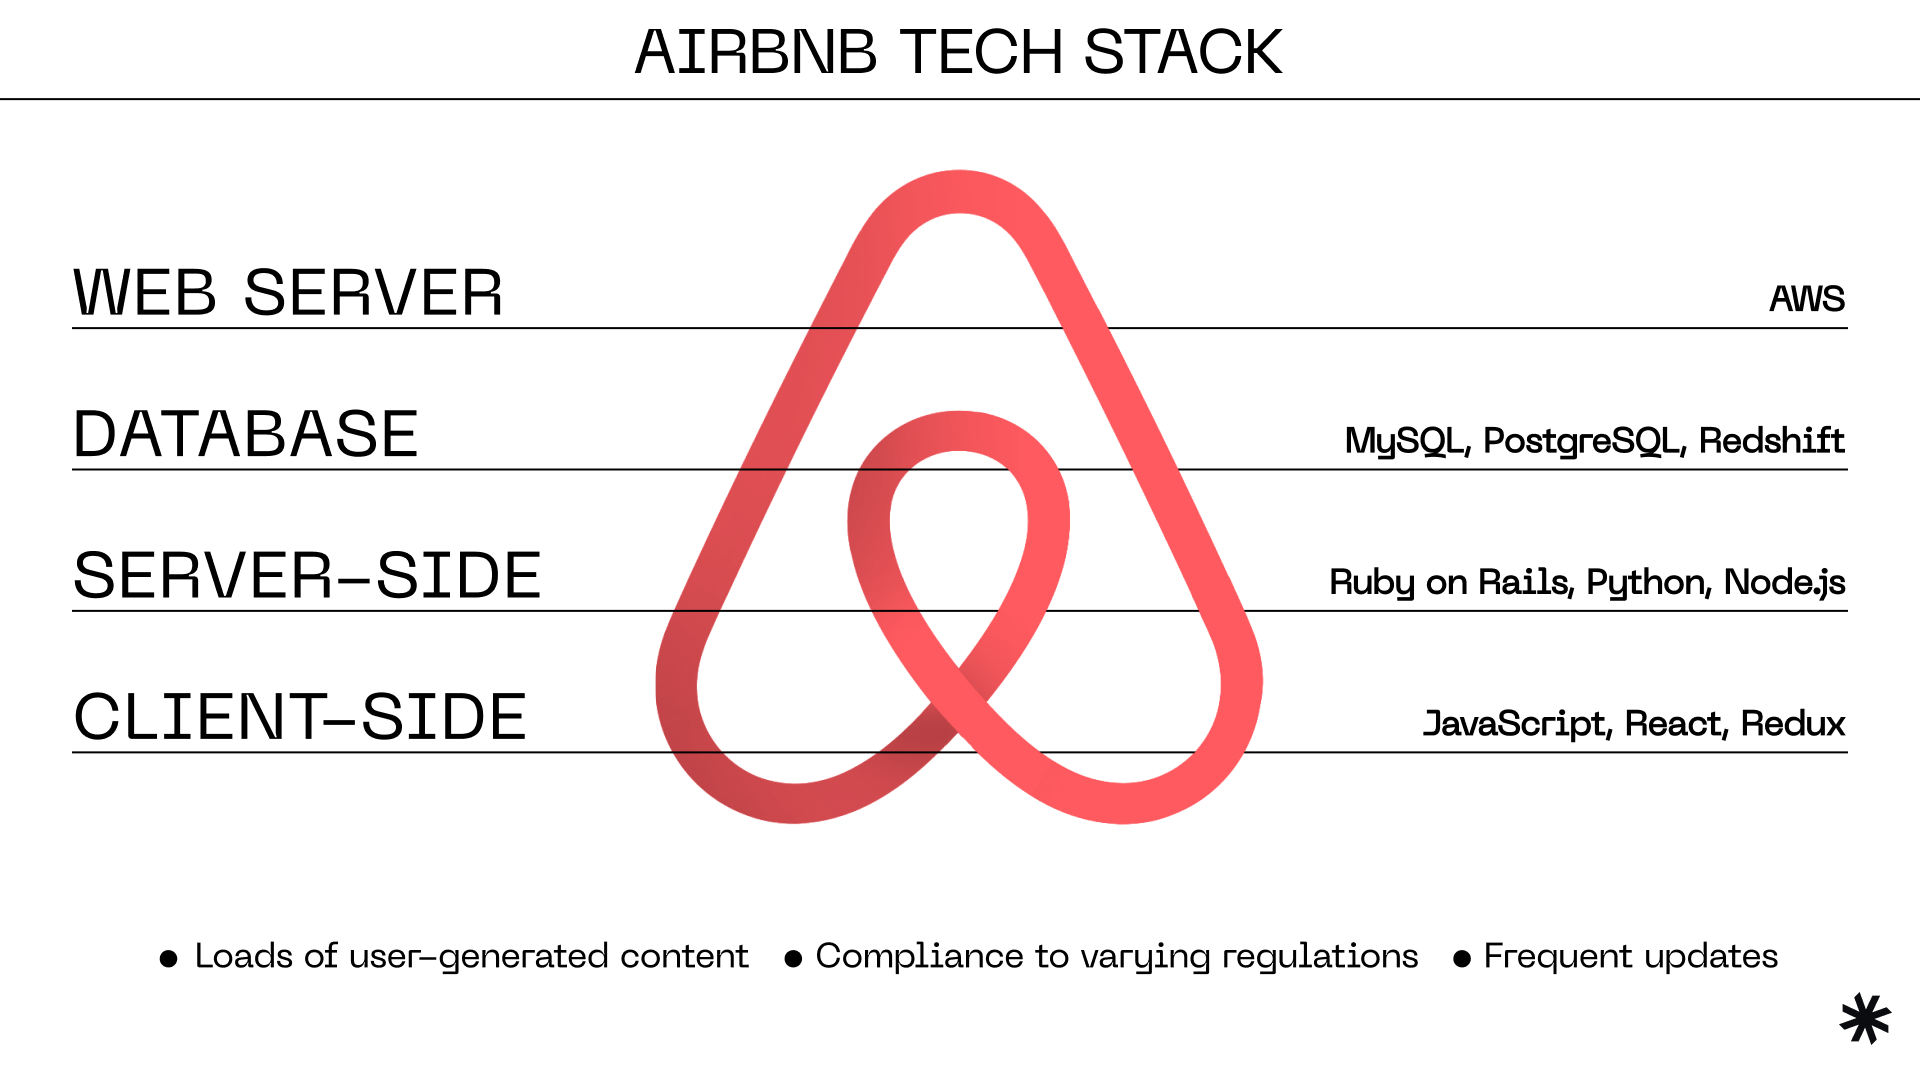
Source : Syndicode
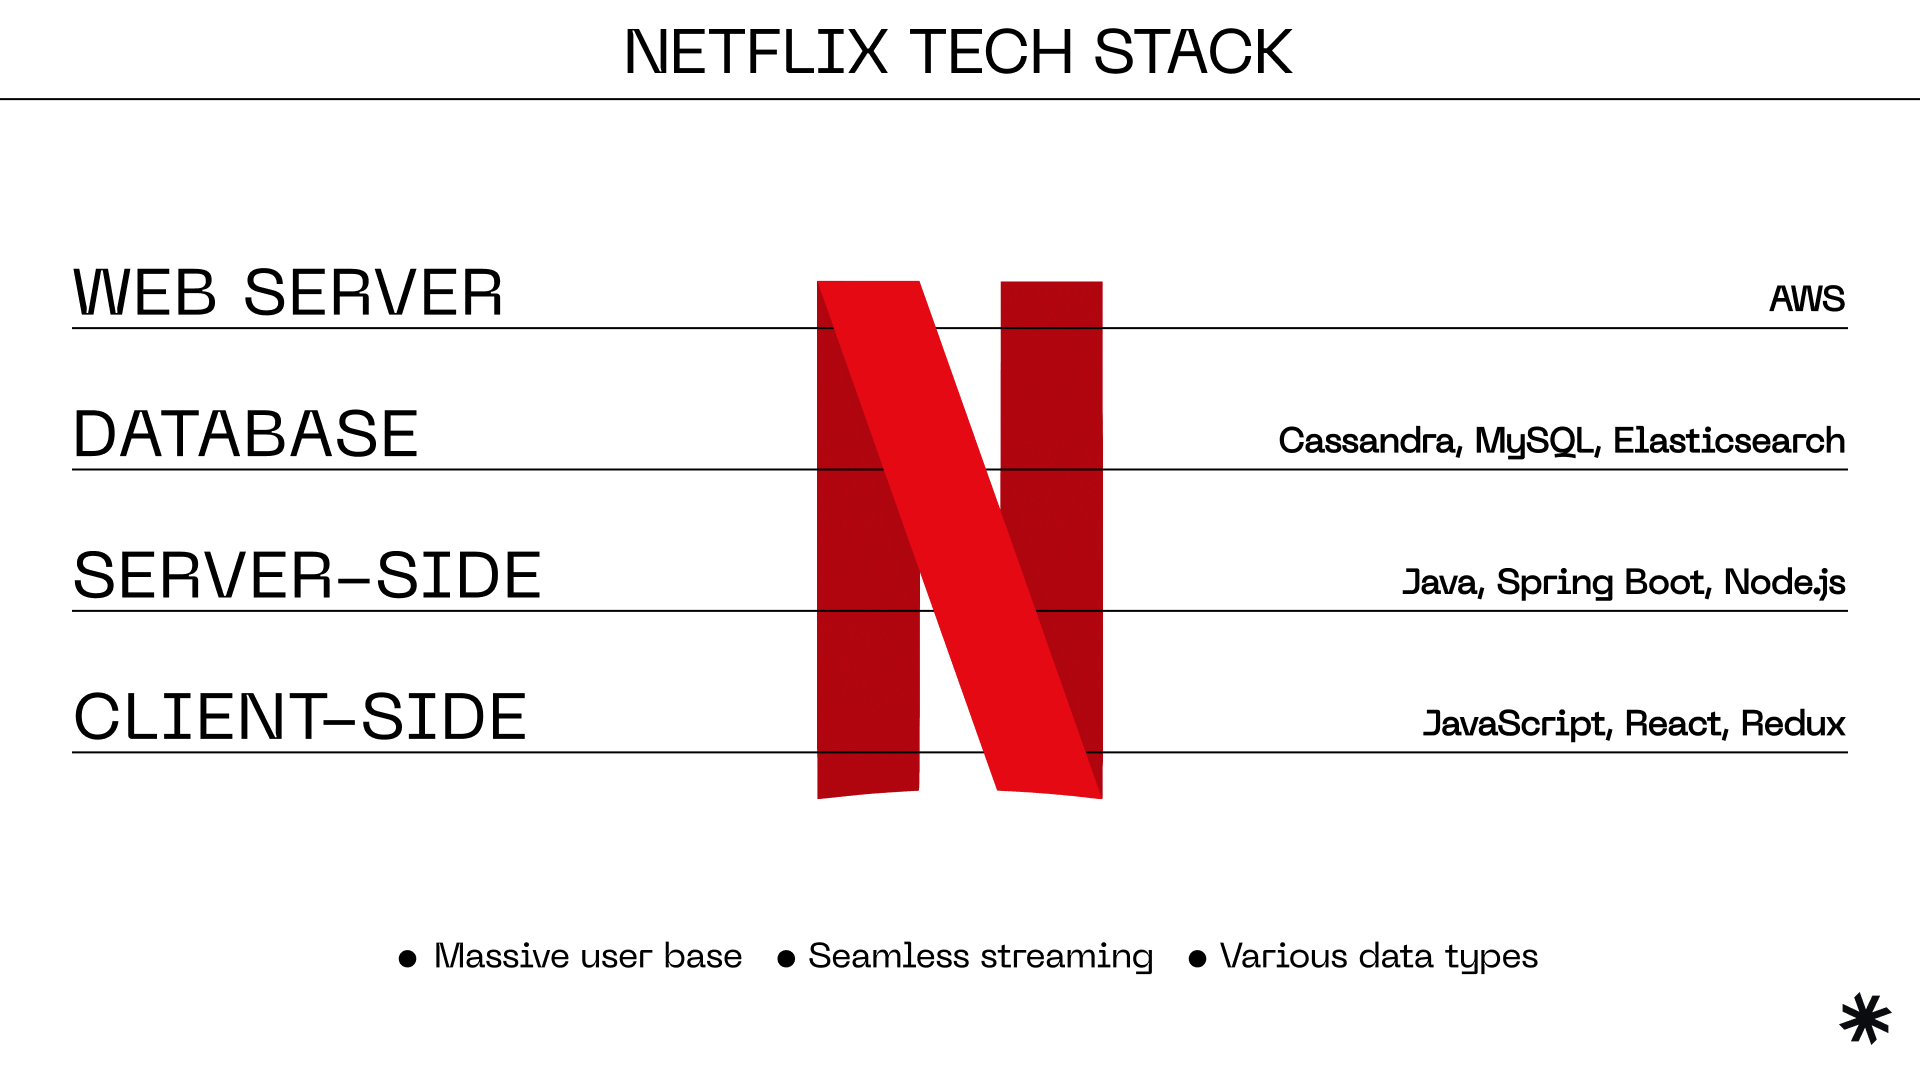
Source : Syndicode
Décrire le périmètre
Une stack peut contenir les couches suivantes :
| Couche | Rôle | Exemples de technologies |
|---|---|---|
| interface | structure, présentation et interactions | HTML, CSS, Angular, React, Alpine.js |
| rendu web | production du HTML et chargement des données | Svelte dans le navigateur, Laravel et Livewire sur le serveur, générateur statique |
| backend | routes, autorisations et règles métier | Express, Laravel, Django, Spring |
| environnement d’exécution | exécution du code applicatif | Node.js, PHP, JVM, Python |
| données | persistance et requêtes | MongoDB, PostgreSQL, MySQL, SQLite |
| serveur web | réception des requêtes, terminaison TLS et distribution des fichiers | Apache, Nginx, Caddy |
| système et hébergement | exécution et livraison des services | Linux, conteneurs, machine virtuelle, plateforme gérée |
Une stack nomme les technologies qui structurent le développement, l’exécution ou le déploiement. Une petite bibliothèque utilitaire n’y figure que si elle impose une contrainte ou un mode de travail qui compte pour le projet.
Stack et architecture répondent à des questions différentes
| Notion | Question |
|---|---|
| stack technique | quelles technologies le projet utilise-t-il ? |
| architecture | comment les parties sont-elles organisées, reliées et déployées ? |
| pattern ou style | quelle forme d’organisation récurrente répond au problème ? |
| stratégie de rendu | où et quand le HTML est-il produit ? |
Deux applications peuvent utiliser la même stack et avoir des architectures différentes. Une application Node.js peut être un monolithe modulaire ou un ensemble de services. À l’inverse, une architecture client-serveur peut utiliser Node.js et MongoDB, ou Laravel et PostgreSQL.
Que signifie full stack ?
Une application dite full stack comprend au moins une interface, un backend et un moyen de stocker les données. Une personne full stack intervient sur plusieurs de ces couches. L’expression ne précise ni les technologies utilisées ni le niveau de maîtrise de chaque couche.
Exemples de stacks
La stack MEAN
MEAN regroupe quatre technologies :
MongoDB base de données orientée documents
Express framework HTTP exécuté avec Node.js
Angular framework d’interface web
Node.js environnement d’exécution JavaScript côté serveur
Dans le navigateur, Angular envoie des requêtes HTTP à Express, qui tourne sur Node.js et interroge MongoDB.
Angular, Express et Node.js utilisent JavaScript ou TypeScript. MongoDB stocke des documents BSON et fournit un pilote pour Node.js. Cette proximité réduit le nombre de langages utilisés, mais elle ne supprime pas les contrats entre le frontend, l’API et la base.
Le nom MEAN ne précise ni l’hébergeur, ni le proxy inverse, ni les outils de test et de livraison. Il ne donne pas non plus les versions. Cette dernière information compte, car un ancien projet MEAN peut utiliser AngularJS tandis qu’un projet récent utilise Angular.
Dans la variante MERN, React remplace Angular.
La stack TALL
TALL appartient à l’écosystème Laravel :
Tailwind CSS production des styles à partir de classes utilitaires
Alpine.js interactions locales dans le navigateur
Laravel framework PHP pour les routes, les règles métier et l’accès aux services
Livewire composants PHP interactifs mis à jour par des requêtes au serveur
sequenceDiagram
  actor P as Personne
  participant N as Navigateur
  participant L as Laravel et Livewire
  participant D as Base de données
  P->>N: modifie un composant
  N->>L: envoie la mise à jour
  L->>D: lit ou modifie les données
  D-->>L: renvoie le résultat
  L-->>N: renvoie le HTML mis à jour
  N->>N: met à jour les éléments concernés
Livewire rend du HTML sur le serveur puis met à jour le document dans le navigateur. Alpine.js gère les interactions qui peuvent rester locales, comme ouvrir un menu. Cette répartition peut limiter le code JavaScript propre au projet. Elle ajoute des requêtes serveur pour les mises à jour Livewire et demande de définir quelles interactions restent dans Alpine.js.
TALL ne précise pas la base de données, le serveur web, le système d’exploitation ou l’hébergeur. Une description exploitable pourrait donc être : TALL avec PostgreSQL, Nginx et Linux, déployé sur une machine virtuelle.
Deux autres exemples
LAMP désigne couramment Linux, Apache, MySQL et PHP. Son périmètre part du système d’exploitation et va jusqu’au langage du backend. Selon les sources, le P peut aussi désigner Perl ou Python. LAMP ne précise pas le framework PHP ni l’organisation du frontend.
Une stack n’a pas besoin d’un acronyme. Un projet peut annoncer simplement : Vue pour l’interface, Laravel pour l’API, PostgreSQL pour les données, Nginx sur Linux pour le déploiement.
Documenter la stack d’un projet
| Couche ou besoin | Technologie et version | Rôle dans le projet | Raison ou preuve | Condition de réexamen |
|---|---|---|---|---|
| interface | ||||
| rendu | ||||
| backend | ||||
| données | ||||
| déploiement |
Ressources
- MongoDB, What Is the MEAN Stack?, distinction entre MEAN, MERN et MEVN.
- TALL stack, Reactive Laravel Apps with the TALL stack, composition de l’acronyme.
- Laravel Livewire, Hydration, échanges entre les composants PHP et le navigateur.
- Ubuntu Server, How to install Apache2, composition courante de LAMP.
Frontend, backend et stratégies de rendu
Une application web répartit le travail entre le navigateur et un ou plusieurs serveurs. La stratégie de rendu indique où et quand le HTML d’une page est produit.
Frontend
Le frontend est la partie du système avec laquelle la personne interagit. Son HTML peut être produit pendant le build, sur un serveur ou dans le navigateur. Le code interactif envoyé au navigateur affiche l’interface, traite les interactions locales et appelle les services dont il dépend.
Le frontend peut masquer un bouton, mais le backend doit encore refuser l’opération si la personne n’a pas le droit de l’exécuter.
Backend
Le backend s’exécute dans un environnement contrôlé par l’équipe ou son hébergeur. Il applique les règles métier qui doivent être partagées ou protégées, vérifie les autorisations, accède aux données persistantes et appelle les services qui nécessitent des secrets.
Le backend n’est pas la base de données. Il contient le code qui décide comment lire et modifier les données. La base les stocke et garantit les contraintes définies dans son schéma et ses transactions.
Le frontend envoie une requête HTTPS au backend. Le backend interroge la base avec une requête paramétrée, puis renvoie la réponse au frontend.
Frontend et backend peuvent vivre dans le même dépôt et être livrés ensemble. Ils peuvent aussi être séparés en plusieurs applications.
CSR : rendu côté client
Avec le client-side rendering, le serveur envoie un document HTML initial, souvent minimal, puis le navigateur charge le JavaScript. Ce code demande les données et construit l’interface.
sequenceDiagram
  participant N as Navigateur
  participant H as Hébergeur web
  participant A as API
  N->>H: demande la page
  H-->>N: HTML et JavaScript
  N->>N: exécute le JavaScript
  N->>A: demande les données
  A-->>N: renvoie les données
  N->>N: construit l'interface
Le CSR convient aux interfaces très interactives dont les personnes sont déjà authentifiées, comme un outil interne. Il permet d’héberger les fichiers du frontend sur un service statique et d’utiliser directement les API du navigateur. Le premier affichage dépend toutefois du téléchargement, de l’analyse et de l’exécution du JavaScript, puis des appels de données. L’application doit aussi gérer les états de chargement et d’erreur.
Un site rendu côté client peut être indexé par certains moteurs de recherche. Le HTML initial, les métadonnées et les aperçus de liens demandent néanmoins une vérification explicite pour chaque robot ou plateforme visée.
React, Vue et Angular peuvent produire une application rendue côté client. Leur nom ne suffit pas à identifier la stratégie, car ces outils disposent aussi d’API ou de frameworks pour le rendu serveur et le prérendu. Angular utilise le CSR par défaut. Une application Nuxt configurée avec ssr: false ou une application SvelteKit configurée sans SSR sont deux autres exemples.
SSR : rendu côté serveur
Avec le server-side rendering, un serveur reçoit une requête pour une URL et produit le HTML de la page à ce moment-là. Il peut lire les données et personnaliser la réponse avant de l’envoyer au navigateur. La réponse contient le contenu nécessaire à l’affichage initial. Certaines données peuvent encore arriver plus tard, notamment lorsque le serveur diffuse le HTML progressivement ou que le navigateur lance d’autres requêtes.
sequenceDiagram
  participant N as Navigateur
  participant S as Serveur de rendu
  participant A as API ou base de données
  N->>S: demande la page
  S->>A: demande les données
  A-->>S: renvoie les données
  S-->>N: renvoie le HTML
Le navigateur reçoit du contenu avant d’exécuter le JavaScript de l’interface. Le SSR demande un environnement capable de produire les réponses qui ne sont pas déjà dans un cache. Sa latence dépend du calcul et des appels de données réalisés avant l’envoi du HTML. Le cache réduit ce coût pour les pages qui partagent le même contenu.
Le SSR peut vivre dans la même application que les règles métier ou appeler un backend séparé. Produire du HTML sur un serveur ne rend pas automatiquement ce serveur responsable de toute la logique du produit.
Next.js, Nuxt, SvelteKit et Angular avec @angular/ssr prennent en charge le SSR. React et Vue fournissent aussi des API de rendu serveur que ces frameworks peuvent utiliser.
Le SSR est adapté à une page publique dont le contenu varie souvent ou dépend de la requête, par exemple une page d’actualité non mise en cache ou un catalogue personnalisé. Le HTML directement exploitable aide les moteurs de recherche et les aperçus de liens.
SSG : génération statique
Avec la static site generation, les pages HTML sont produites pendant le build. L’hébergement distribue ensuite des fichiers déjà générés, souvent depuis un CDN.
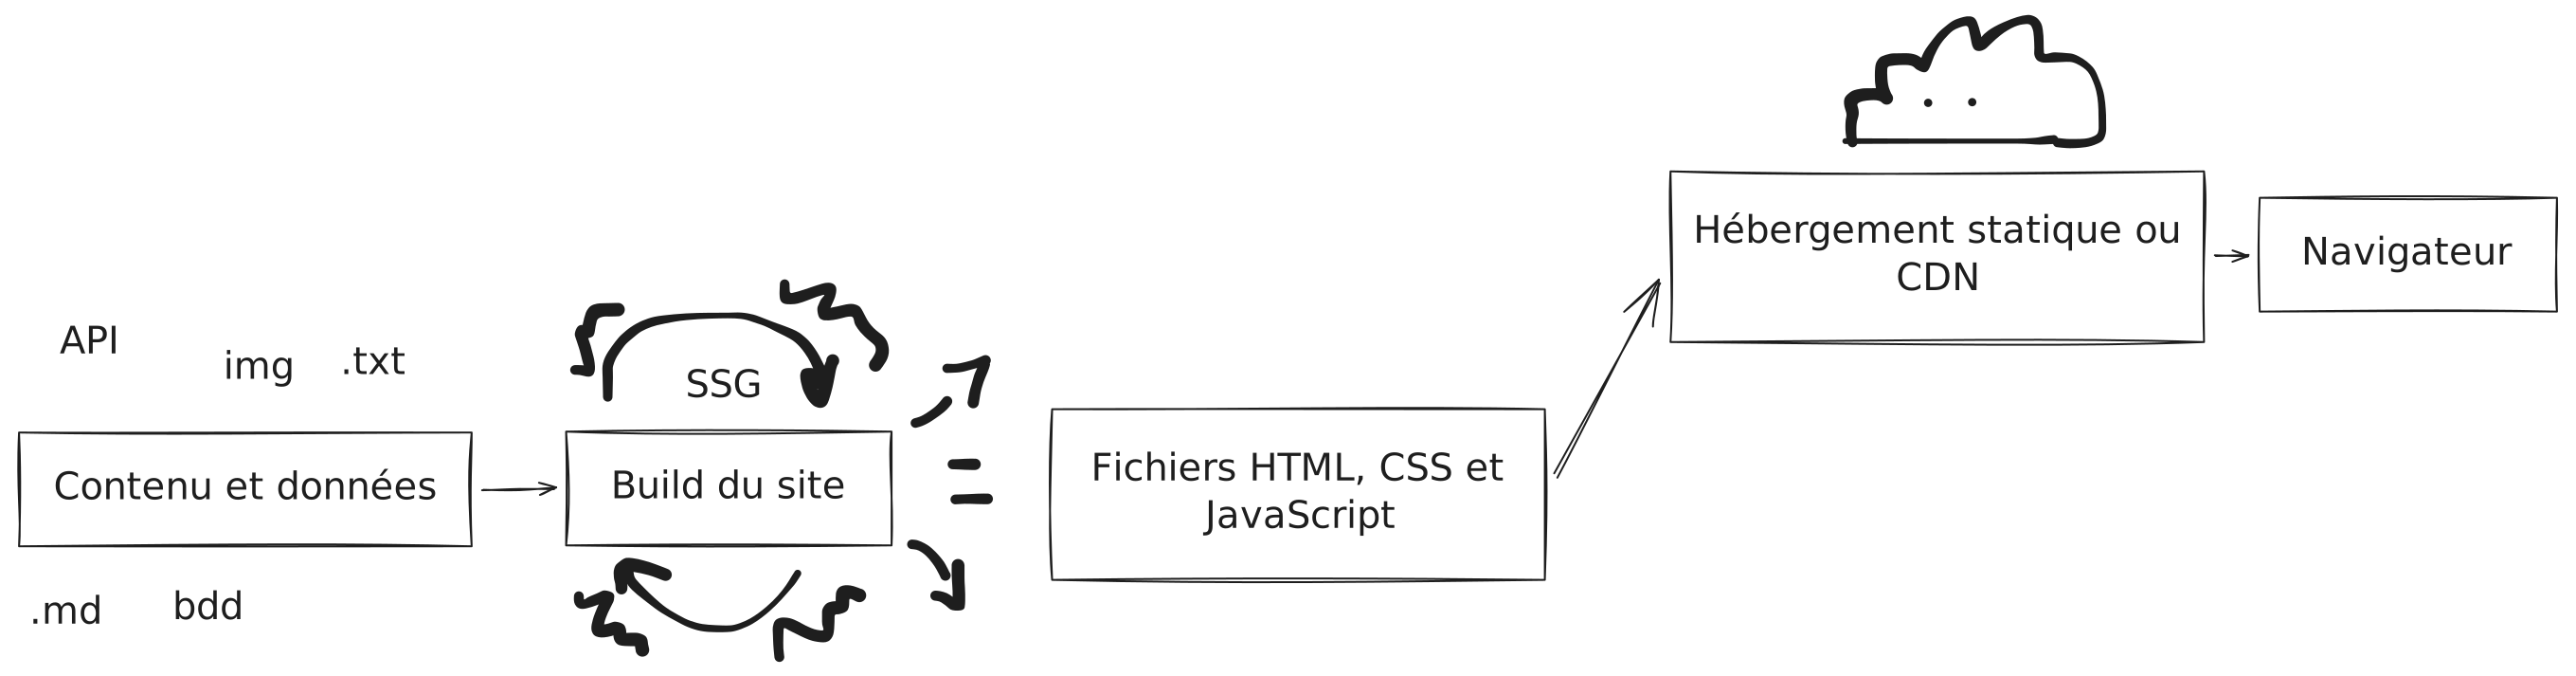
Le SSG convient à une documentation, un blog, un portfolio ou des pages de présentation dont le contenu change moins souvent que les consultations. Le serveur n’a pas besoin de recalculer la page pour chaque visite. Les fichiers peuvent être distribués par un hébergement statique ou un CDN.
Une modification demande une nouvelle génération. Une page statique peut encore appeler une API dans le navigateur pour afficher une partie dynamique ou personnalisée.
Hydratation
Une page SSR ou SSG peut contenir du JavaScript interactif. L’hydratation relie ce JavaScript au HTML déjà présent dans le navigateur et attache les gestionnaires d’événements.
Une page visible n’est pas forcément encore interactive. Si l’hydratation charge et exécute beaucoup de JavaScript, un bouton peut apparaître avant de répondre aux clics.
SPA : navigation sans rechargement complet
Une single-page application intercepte les changements de route dans le navigateur. Après le chargement initial, le routeur JavaScript remplace la vue et met à jour l’URL sans demander au navigateur de charger un nouveau document HTML complet.
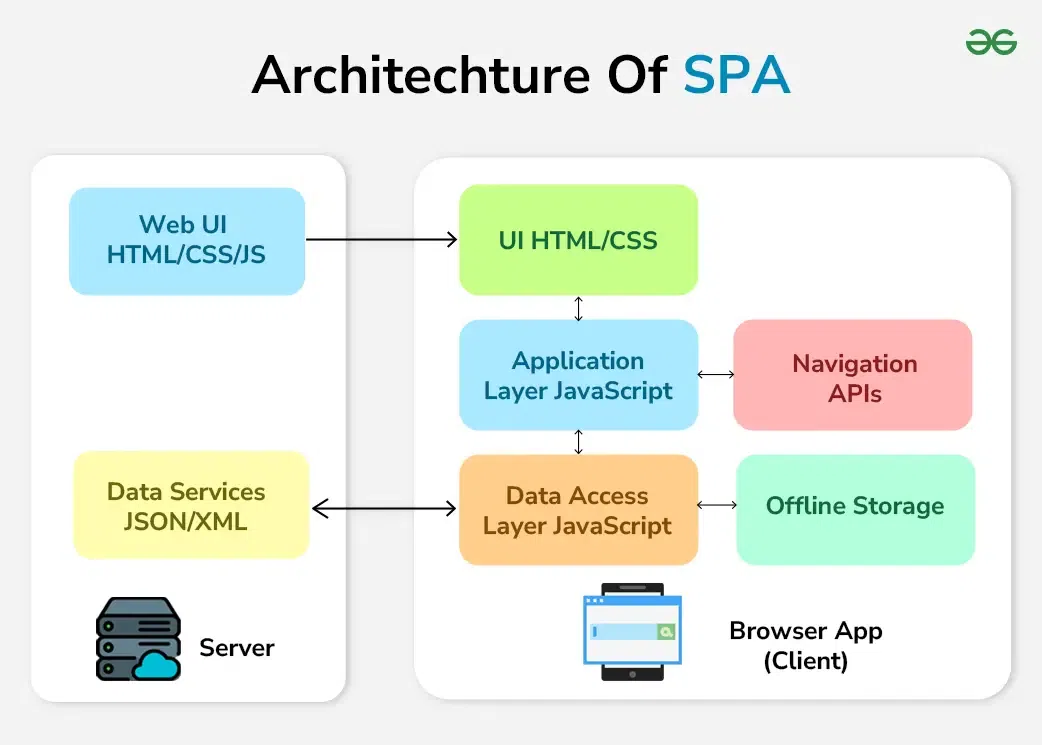
SPA et CSR ne sont pas synonymes. Une SPA entièrement CSR construit son premier écran dans le navigateur. Une application SSR ou SSG peut envoyer un premier HTML complet, l’hydrater, puis utiliser une navigation SPA pour les routes suivantes. Next.js, Nuxt et SvelteKit peuvent suivre ce second fonctionnement.
À l’inverse, une application multipage, ou MPA, laisse le navigateur demander un nouveau document HTML à chaque changement de page. Ce fonctionnement peut être rendu sur le serveur ou servi depuis des fichiers statiques.
Rendu hybride
Une application peut choisir une stratégie par route ou par fragment de page. Un site de réservation peut générer ses pages de présentation au build, rendre le catalogue sur le serveur et laisser le tableau de bord utiliser le CSR après authentification.
Cette combinaison adapte le rendu au besoin de chaque page. Elle ajoute aussi plusieurs politiques de cache, de chargement et de déploiement. Documente la stratégie choisie pour chaque groupe de routes afin qu’une page ne change pas de comportement par défaut lors d’une mise à jour du framework.
Un site d’actualité n’a donc pas besoin de rendre toutes ses pages sur le serveur à chaque requête. Il peut générer les articles, les régénérer après une publication, mettre en cache la page d’accueil et réserver le SSR aux pages personnalisées.
Exemples de frameworks et d’outils
| Outil | Capacités illustrées | Précision |
|---|---|---|
| Next.js | rendu serveur, rendu statique, rendu client et régénération | le mode dépend des composants, des données et du cache |
| Nuxt | rendu universel, CSR, prérendu et rendu hybride | des règles peuvent être définies par route |
Angular avec @angular/ssr | CSR, SSR et prérendu | Angular Universal est l’ancien nom rencontré dans certains projets |
| SvelteKit | SSR, prérendu, CSR et SPA | les options peuvent être choisies par page ou groupe de pages |
Avantages et limites
| Question | CSR | SSR | SSG |
|---|---|---|---|
| Moment du rendu initial | dans le navigateur | lors de la requête si la réponse n’est pas déjà en cache | pendant le build |
| Infrastructure pour le HTML | hébergement de fichiers | serveur de rendu | hébergement de fichiers ou CDN |
| Données personnalisées dans le HTML initial | généralement chargées après | possibles à chaque requête | possibles pour les variantes connues au build |
| Fraîcheur du contenu | au moment de l’appel API | au moment de la requête | au dernier build ou à la dernière régénération |
| Cas fréquent | tableau de bord ou outil interne | contenu public dynamique ou personnalisé | documentation, portfolio ou pages de présentation |
| Avantage principal | hébergement simple et logique interactive dans le navigateur | HTML calculé avec les données de la requête | fichiers précalculés faciles à mettre en cache |
| Limite à mesurer | temps avant affichage, volume de JavaScript et indexation | latence, charge serveur, cache et coût d’exploitation | durée du build, fraîcheur et nombre de pages |
Questions de décision
- Le contenu est-il public, personnalisé ou protégé ?
- À quelle fréquence change-t-il ?
- Quelle partie doit être visible avant l’exécution du JavaScript ?
- Quel délai de mise à jour du contenu est acceptable ?
- L’équipe peut-elle exploiter un serveur de rendu ?
- Comment la page se comporte-t-elle si JavaScript ou une API tarde à répondre ?
- Quelles mesures valideront le choix sur les appareils et réseaux ciblés ?
Ressources
- MDN, Server-side rendering.
- MDN, SPA, définition et compromis d’une application monopage.
- web.dev, Rendering on the Web.
- Angular, Server-side and hybrid rendering.
- Nuxt, Rendering Modes.
- SvelteKit, Page options.
- SvelteKit, Single-page apps.
- Next.js, Static and Dynamic Rendering.
- React, Server React DOM APIs.
- React,
hydrateRoot, attachement de React à un HTML produit sur le serveur. - Vue, Server-Side Rendering.
Patterns, styles et abstractions
Client-serveur et séparation frontend/backend
Dans une architecture client-serveur web, le navigateur envoie des requêtes à un serveur. La séparation frontend/backend place l’interface et l’API dans deux applications. Le back expose les données, le front les consomme et les affiche. Les deux applications se déploient, se versionnent et se testent séparément.
Le front, une application JavaScript, envoie des requêtes HTTP à l’API REST du back et reçoit du JSON. Seul le back accède à la base de données. Un projet peut ranger ces applications dans des dossiers client/ et server/, ou dans deux dépôts distincts.
Deux applications demandent deux chaînes de livraison et un moyen de synchroniser les contrats de données. Une configuration CORS est nécessaire si elles utilisent des origines différentes. Cette séparation convient lorsqu’une même API alimente plusieurs clients, par exemple web et mobile, ou lorsque les équipes front et back livrent à des rythmes différents. Pour un site vitrine, un monolithe ou un générateur statique demande généralement moins d’exploitation. Le chapitre Frontend, backend et stratégies de rendu détaille les responsabilités et les options de rendu.
Monolithe modulaire
Un monolithe est livré comme une seule unité. Chaque module regroupe une capacité métier, expose une interface et garde ses détails privés.
Cette organisation évite la coordination réseau entre modules et permet des transactions locales. Elle demande toutefois des règles de dépendance vérifiées par les tests ou les outils de build. Sans ces règles, les modules finissent par accéder directement aux données et au code interne des autres.
Organisation interne d’une application
Architecture en couches
Une architecture en couches sépare par exemple la présentation, les cas d’usage, le domaine et l’infrastructure. Chaque couche a une responsabilité et des dépendances autorisées. La règle choisie doit être explicite afin d’éviter les appels circulaires et les accès directs à la base depuis l’interface.
Ce découpage aide lorsqu’une même règle métier est utilisée par plusieurs interfaces. Il ajoute des passages entre couches et peut disperser une petite fonctionnalité dans plusieurs fichiers.
MVC (Modèle, Vue, Contrôleur)
MVC sépare trois responsabilités : les données et règles métier dans le modèle, leur affichage dans la vue et le traitement des actions dans le contrôleur. Cette séparation permet de modifier l’affichage sans réécrire les règles métier, tant que les interfaces entre les trois parties restent stables.
Laravel, Rails, Django et Symfony proposent des organisations inspirées de MVC. Des dossiers models/, views/ et controllers/ en sont un indice, même si leur présence ne garantit pas que les responsabilités sont bien séparées.
flowchart LR
  U["Navigateur"] -- "requête" --> C["Contrôleur"]
  C -- "demande les données" --> M["Modèle"]
  M -- "règles métier + données" --> C
  C -- "passe les données" --> V["Vue"]
  V -- "HTML" --> U
Cette séparation ajoute de l’indirection : suivre une requête demande de passer par plusieurs fichiers. Sur un petit script, ce découpage peut coûter plus de temps qu’il n’en fait gagner. Il devient utile lorsque les règles métier, les entrées et les affichages évoluent indépendamment.
Style d’interface
REST
REST est un style d’architecture fondé notamment sur des ressources, une interface uniforme et des requêtes qui contiennent les informations nécessaires à leur traitement. Dans une API HTTP, une URL peut identifier une ressource comme /users/42. Les méthodes expriment l’opération demandée : GET lit une représentation, POST soumet ou crée une ressource selon l’API, PUT la remplace et DELETE la supprime. Les codes de statut, comme 200, 404 ou 500, décrivent le résultat de la requête.
De nombreuses API publiques et applications web qui échangent du JSON suivent ces conventions. Un appel comme fetch("/api/cart") peut demander la représentation de la ressource panier.
Le modèle par ressources représente moins bien certaines opérations, comme recalculer un itinéraire ou valider un tour de jeu. Les transformer artificiellement en ressources rend parfois l’API moins lisible. Choisis une convention cohérente avec le domaine et documente les exceptions.
Accès aux données
ORM (Object-Relational Mapping)
Un ORM traduit entre les objets du langage et les tables SQL. Le code accède par exemple à user.favorites, puis l’ORM génère la requête correspondante. Prisma, Sequelize, Eloquent, Hibernate et Doctrine appartiennent à cette famille.
L’abstraction peut masquer le coût des requêtes générées. Un N+1 charge une liste, puis exécute une requête supplémentaire pour chaque élément au lieu de regrouper le chargement. Il reste invisible tant que l’équipe n’inspecte pas les requêtes ou leurs mesures. L’ORM ajoute aussi une API à apprendre. En échange, il automatise la conversion entre objets et tables et fournit généralement des requêtes paramétrées. Celles-ci réduisent le risque d’injection SQL lorsque l’application n’insère pas de fragments SQL non contrôlés.
Ces patterns se situent à des niveaux différents : déploiement, organisation interne, interface, accès aux données. Les ranger par niveau évite de comparer des solutions qui ne répondent pas à la même question. Un monolithe peut utiliser MVC, exposer une API REST et accéder aux données avec un ORM. Ces choix se combinent et chacun demande sa propre justification.
D’autres patterns existent : Jamstack, backend for frontend, microservices. Chacun répond à un problème et ajoute ses propres contraintes. Le nom du pattern ne suffit pas à justifier un choix : la décision décrit aussi le contexte dans lequel il s’applique.
Les critères d’un choix technique
Compare les options à partir de critères définis avant l’évaluation. Sinon, il devient facile d’adapter les critères à l’option que l’on préfère déjà.
Les critères les plus communs
Maintenabilité. Dans six mois, quelqu’un d’autre pourra-t-il comprendre, corriger et faire évoluer ce choix ? La techno est-elle documentée ? L’équipe la connaît-elle ? Trouve-t-on des réponses quand on cherche une erreur ?
Complexité. Compte les services, les dépendances et les couches que l’option ajoute. Chacun demande de la configuration, du suivi et des connaissances pour diagnostiquer une panne. Ce coût apparaît à chaque correction et à chaque évolution du projet.
Évolutivité (scaling). Estime la charge réaliste et son évolution. Dimensionner un outil pour une charge très supérieure aux prévisions ajoute des coûts sans répondre au besoin actuel. Demande quelle charge l’option supporte et combien coûterait une migration si cette limite était dépassée.
Délai et coût. Intègre le temps d’apprentissage, l’implémentation, l’hébergement et les licences. Une technologie inconnue de l’équipe peut coûter plus cher qu’une option déjà maîtrisée, même si elle obtient de meilleurs résultats sur un autre critère.
Réversibilité. Évalue le travail nécessaire pour changer d’option : migration des données, adaptation du code, formation et interruption de service. Une décision facile à inverser peut être testée rapidement. Une décision coûteuse à inverser mérite une comparaison documentée dans un ADR.
Maturité de la solution. La simplicité et la maturité sont deux critères distincts. Une solution récente peut être simple. Une solution ancienne peut accumuler de nombreuses options et demander davantage de configuration.
Pour évaluer la maturité, regarde la fréquence des versions, la durée de support, le traitement des failles, le nombre de mainteneurs actifs et la stabilité des interfaces. Pour évaluer la simplicité, compte les composants, les configurations et les connaissances nécessaires à l’exploitation.
Sécurité. Vérifie les recommandations auprès des organismes et spécifications concernés, puis contrôle leur date. Consulte par exemple OWASP, les avis de sécurité associés aux CVE et les RFC. Pour le stockage des mots de passe, la fiche OWASP Password Storage recommande Argon2id pour une nouvelle application et réserve bcrypt aux systèmes anciens où Argon2 et scrypt ne sont pas disponibles.
Observabilité. Détermine ce que l’équipe doit pouvoir expliquer pendant un incident. Les journaux, métriques et traces doivent permettre de relier une erreur à une requête, d’identifier le composant concerné et de mesurer la durée du problème. Collecter des données sans question opérationnelle produit du volume sans aider au diagnostic.
Testabilité. Évalue la possibilité de tester les règles métier sans dépendre d’un réseau ou d’un service tiers, la durée de la suite de tests et la reproductibilité des environnements. Une architecture difficile à isoler ralentit la détection des régressions.
Interopérabilité. Liste les systèmes qui échangent des données, les formats, les protocoles et les règles de version. Un contrat d’API doit préciser comment un consommateur ancien réagit lorsqu’un champ ou une opération change.
Critères de contexte et de valeurs
Certains projets ajoutent des critères liés aux droits d’usage, à l’organisation qui maintient le produit ou au lieu d’hébergement des données.
Licence. La licence définit les droits d’utilisation, de modification et de redistribution. Vérifie aussi les conditions commerciales, l’accès au code source et les possibilités d’export. Ces éléments déterminent ce que le client pourra faire si l’éditeur arrête le produit ou change ses tarifs.
Gouvernance et santé du projet. Identifie qui maintient la technologie : une entreprise, une fondation ou une communauté. La popularité passée ne suffit pas. Regarde la fréquence des versions, le traitement des signalements de sécurité, le nombre de mainteneurs actifs, les règles de gouvernance et la politique de compatibilité. Une dépendance tenue par une seule personne ou qui rompt souvent son API augmente le travail de suivi et de migration.
Souveraineté. Demande où sont stockées les données, quelle juridiction s’applique, comment les exporter et qui peut couper le service. Pour des données personnelles ou de santé, la réglementation et le contrat peuvent imposer des conditions d’hébergement supplémentaires. Prévoir la sortie dès le choix initial permet d’estimer le format d’export, le délai et le coût d’une migration.
Dépendances. Chaque dépendance ajoute du code à auditer, des mises à jour à suivre et une API susceptible d’évoluer. Par exemple, le fetch natif suffit pour de nombreux appels HTTP simples dans les navigateurs modernes. Dans ce cas, ajouter Axios introduit une dépendance sans apporter de capacité nécessaire. Axios reste pertinent si le projet a besoin de ses fonctions propres ou doit prendre en charge des environnements que fetch ne couvre pas.
Éliminer les options incompatibles puis comparer
Une contrainte élimine une option. Un critère sert ensuite à comparer les options restantes.
- Liste les contraintes et retire les options qui ne les respectent pas.
- Choisis quatre à six critères qui correspondent au projet.
- Attribue leur poids avant d’évaluer les options.
- Définis une même échelle de notation pour toutes les options.
- Ajoute la source de chaque note ou marque-la comme hypothèse.
- Modifie un poids à la fois pour vérifier si le résultat dépend d’un seul jugement fragile.
Voici une grille d’exercice pour un outil associatif de réservation de salles. Les deux options respectent deux contraintes posées avant la comparaison : hébergement dans l’Union européenne et export complet des réservations. Les poids vont de 1 à 3. Les notes vont de 1, résultat défavorable, à 5, résultat favorable.
| Critère | Poids | SaaS, note | SaaS, résultat | Auto-hébergé, note | Auto-hébergé, résultat |
|---|---|---|---|---|---|
| Délai de mise en route | 3 | 5 | 15 | 2 | 6 |
| Exploitation technique | 3 | 5 | 15 | 2 | 6 |
| Coût estimé sur 3 ans | 2 | 2 | 4 | 4 | 8 |
| Souveraineté des données | 3 | 2 | 6 | 5 | 15 |
| Réversibilité | 2 | 3 | 6 | 5 | 10 |
| Total | 46 | 45 |
Dans cet exemple, le SaaS réduit le délai de mise en route et le besoin de compétences internes. L’option auto-hébergée donne davantage de contrôle sur les données, réduit le coût estimé sur trois ans et facilite la migration. Un point d’écart sépare les deux totaux : passer le poids du coût de 2 à 3 suffit à inverser le résultat. Ce genre d’écart se tranche avec le client, pas avec la grille. L’ADR conserve la comparaison et la raison du choix.
Évaluer aussi le coût des critères de valeur
Un critère de valeur doit être évalué comme les autres. Une option auto-hébergée et limitée en dépendances peut demander plus de temps, des compétences internes et davantage d’exploitation. Inscris ces coûts dans la comparaison afin que la décision reste révisable si le contexte change.
Ressources
- Software Engineering Institute, Deriving Architectural Tactics: A Step Toward Methodical Architectural Design, annexe sur les scénarios de qualité.
- ISO, ISO/IEC 25010:2023, modèle de qualité des produits logiciels et systèmes informatiques.
Comment faire des choix
Tout choix comporte un compromis. Si une option semble n’avoir aucun inconvénient, alors son coût n’a pas encore été identifié (Fundamentals of Software Architecture, 2020).
Une décision d’architecture est un choix technique avec des conséquences qui structurent la vie du projet. Elle s’argumente : elle dit pourquoi une option répond mieux qu’une autre aux contraintes du projet. React ou Vue, PostgreSQL ou SQLite, Axios ou fetch, JWT ou session, Express ou Laravel : chacun de ces choix peut en être une.
Michael Nygard considère comme des choix d’architecture les décisions qui touchent à la structure du système, ses caractéristiques de qualité, ses dépendances, ses interfaces ou la façon dont le projet est construit. La portée, le coût d’un retour en arrière et la durée de ses effets déterminent le niveau de documentation nécessaire. On ne documente pas tous les choix. Un choix qui change un seul fichier et se remplace sans migration est un détail de conception. Un choix qui touche plusieurs composants, impose un contrat entre équipes ou demande une migration mérite d’être documenté.
Ce schéma aide à trier un choix à documenter d’un détail de conception :
flowchart TD
  A["Un choix technique"] --> B{"Touche la structure, une qualité, une dépendance, une interface ou le déploiement ?"}
  B -- non --> F["Détail de conception"]
  B -- oui --> C{"Effets étendus, durables ou coûteux à inverser ?"}
  C -- non --> D["Décision de conception locale"]
  C -- oui --> E["Décision d'architecture"]
  E --> G["Critères explicites et ADR"]
Portée du changement
Remplacer une base de données peut demander de convertir les données, d’adapter les requêtes et de revoir le déploiement. Modifier une couleur isolée touche moins de composants. La différence vient du travail de migration et du nombre de contrats modifiés, pas du nom de la technologie.
Choix qu’elle rend possibles
Choisir un framework front oriente la gestion de l’état, le routage et les tests. Le choix initial réduit ou augmente les options compatibles par la suite.
Effets sur les qualités du système
Une décision qui modifie un objectif mesurable de performance, de sécurité, de disponibilité ou de maintenabilité touche l’architecture.
Contrats partagés
Une interface publique, un format de message ou une stratégie d’authentification coordonne plusieurs parties du système. Sa modification demande d’identifier les consommateurs et d’organiser leur migration.
Contraintes, critères, hypothèses et preuves
| Type | Rôle | Exemple pour un hébergement |
|---|---|---|
| Contrainte | élimine les options incompatibles | le contrat impose un hébergement des données dans l’Union européenne |
| Critère | compare les options encore possibles | coût d’exploitation sur trois ans |
| Hypothèse | énonce une information non vérifiée | moins de 20 personnes utiliseront le service en même temps |
| Preuve | documente, mesure ou contredit une affirmation | les journaux des 90 derniers jours montrent un maximum de 12 sessions simultanées |
Traite les contraintes avant la comparaison. Marque les hypothèses comme telles et indique comment les vérifier.
Une préférence peut devenir une décision
L’explicitation transforme une préférence en décision argumentée. “Je préfère SQLite” est une préférence. “Je choisis SQLite parce que la base restera sur la même machine que l’application et que les écritures observées sont brèves et peu fréquentes. La base ne demande pas de serveur séparé. Nous réexaminerons le choix si la contention provoque des erreurs ou si plusieurs serveurs doivent accéder aux mêmes données” est une décision. L’option reste la même, mais les critères, les observations et le seuil de réexamen sont visibles.
Le même raisonnement s’applique aux critères de valeur. “Je ne veux pas de produit Google” exprime une préférence. “Je choisis une solution qui permet au client d’héberger et d’exporter ses données, car cette autonomie est une exigence de la structure ESS” formule une décision argumentée. Les valeurs peuvent guider le choix si elles sont annoncées comme des critères et accompagnées de leurs conséquences.
Documenter les raisons
La deuxième loi de Richards et Ford dit que le pourquoi compte plus que le comment. Le code montre comment la solution fonctionne, mais il ne conserve pas les alternatives écartées ni les contraintes du moment. Un ADR enregistre ces raisons au moment de la décision.
ADR
Documenter les décisions techniques
Michael Nygard a proposé les ADR (Architecture Decision Records) en 2011, dans un billet intitulé “Documenting Architecture Decisions”. Son constat : les documents d’architecture volumineux sont difficiles à lire et à maintenir. Quand les raisons d’un choix ne sont pas écrites, une nouvelle équipe risque de le conserver ou de le remplacer sans connaître les contraintes auxquelles il répondait.
Nygard propose un fichier court par décision, stocké dans le dépôt avec le code. Le livre Software Architecture: The Hard Parts (Ford, Richards, Sadalage, Dehghani, 2021) utilise aussi des ADR pour suivre les décisions prises au fil d’un projet.
Format d’un ADR
# ADR-007 : SQLite comme base de données
---
auteur: Théo
domaine : backend
status-validated : 2026-07-07
---

## Contexte
L'outil de gestion des membres de l'association est utilisé depuis un seul poste et contient environ 400 enregistrements. L'association n'a pas d'administrateur système et ne souhaite pas maintenir un serveur de base de données. L'équipe connaît SQL.

## Contraintes et critères
Contraintes : la base reste sur la même machine que l'application et la sauvegarde doit pouvoir être réalisée sans administration de serveur.
Critères : temps d'exploitation, facilité de sauvegarde, prise en charge des écritures observées et coût de migration.

## Hypothèses et preuves
L'association confirme qu'un seul poste utilise actuellement l'application. Le volume et la durée des écritures n'ont pas encore été mesurés. Le coût d'une migration vers PostgreSQL reste une hypothèse tant qu'un essai n'a pas validé le schéma et les requêtes.

## Décision
Nous utilisons SQLite. La base tient dans un fichier et ne demande aucun serveur de base de données à installer ni à maintenir.

## Alternatives considérées
PostgreSQL auto-hébergé : prend en charge davantage d'écritures concurrentes, mais ajoute un serveur à administrer.
Airtable ou autre SaaS : ne demande pas d'administration de serveur, mais stocke les données personnelles des membres chez un tiers. Cette option ne respecte pas la contrainte d'hébergement définie avec l'association.

## Conséquences
Le déploiement ne nécessite pas de serveur de base de données. Une sauvegarde consiste à copier le fichier SQLite lorsque l'application n'écrit pas dedans.

SQLite ne traite qu'une écriture à la fois par fichier. Des transactions courtes peuvent se succéder, mais une charge d'écriture soutenue peut produire de l'attente ou des erreurs de verrouillage.

## Réexamen
L'association et l'équipe conviennent de rouvrir la décision si l'application doit accéder directement au fichier depuis plusieurs machines, si elle doit fonctionner sur plusieurs serveurs, ou si les mesures montrent que plus de 1 % des écritures dépassent 500 ms ou échouent à cause d'un verrou sur une période de sept jours.
Le format de Nygard contient un titre, un statut, le contexte, la décision et ses conséquences. Les sections “alternatives considérées”, “hypothèses et preuves” et “réexamen” n’en faisaient pas partie. Elles conservent les options écartées, l’incertitude restante et les conditions qui rendraient la décision caduque.
Version minimale
Une petite décision peut tenir en quelques lignes.
# ADR-003 : fetch natif plutôt qu'Axios

## Contexte
Application simple, navigateurs modernes uniquement.

## Décision
Utiliser fetch natif pour les appels HTTP.

## Conséquences
+ aucune dépendance supplémentaire à auditer et à mettre à jour
+ API fournie par les navigateurs ciblés
- gestion du JSON et des erreurs un peu plus verbeuse
Adapte le niveau de détail aux effets de la décision. Un choix de base de données peut demander une page. Un choix de bibliothèque peut tenir en dix lignes. Dans les deux cas, donne le contexte et au moins une conséquence négative.
Plus de modèles : modèles d’ADR en français
Règles de rédaction et de suivi
Remplacer un ADR sans effacer l’ancien
Ne réécris pas un ADR accepté lorsqu’une décision change. Rédige un nouvel ADR, marque l’ancien comme remplacé et ajoute une référence vers son successeur. L’historique montre alors dans quel contexte chaque décision s’appliquait.
stateDiagram-v2
  [*] --> Proposé
  Proposé --> Accepté : review d'équipe
  Proposé --> Rejeté : review d'équipe
  Accepté --> Remplacé : un nouvel ADR le supersede
  Remplacé --> [*]
Décrire le contexte
SQLite répond ici à un usage depuis un seul poste, avec environ 400 enregistrements et sans administrateur système. Un service qui reçoit de nombreuses écritures simultanées et exige une haute disponibilité poserait d’autres contraintes. Sans volume, mode d’accès, compétences disponibles et exigences d’exploitation, le nom de la technologie ne suffit pas à juger le choix.
Rester court
Nygard recommande une ou deux pages. Un format court réduit le temps de rédaction et permet de relire les décisions avec le code.
Versionner les ADR avec le code
Range les fichiers Markdown dans un dossier comme docs/adr/ et numérote-les (001-, 002-). Le même historique relie alors une décision aux changements de code concernés.
Nommer les conséquences négatives
Liste au moins un coût, une limite ou un risque. Si aucune conséquence négative n’apparaît, la comparaison des options est probablement incomplète.
Rendre l’incertitude visible
Sépare les faits observés des hypothèses. Pour chaque hypothèse qui peut changer la décision, indique la mesure, le test ou la personne qui permettra de la vérifier. Une estimation sans décomposition ni essai reste une hypothèse.
L’équipe peut relire un ADR dans la même pull request que le code concerné. Les conventional comments s’appliquent aussi à ce document :
question: le seuil de 1 % sur sept jours vient-il d'un besoin validé ou d'une hypothèse de l'équipe ?

issue (blocking): aucune conséquence négative listée, or tout choix a un coût. Qu'est-ce qu'on perd avec cette option ?

praise: la section "Réexamen" donne des événements et une mesure observables.
Quand une revue de code soulève un choix structurant, par exemple “pourquoi un ORM ici ?”, demande un ADR plutôt que de disperser la décision dans le fil de discussion de la pull request.
Ressources
- Michael Nygard, “Documenting Architecture Decisions” (2011) : le billet d’origine, très court.
- Ford, Richards, Sadalage, Dehghani, Software Architecture: The Hard Parts (2021) : des ADR appliqués à un récit de projet.
- Clements et al., Documenting Software Architectures (SEI) : une méthode plus détaillée pour documenter une architecture.
- Architecture Decision Record - Martin Fowler
- SQLite, Appropriate Uses For SQLite : limites liées aux accès réseau et aux écritures concurrentes.
Exercice : justifier ses choix techniques
Objectif : représenter le projet, inventorier ses choix techniques, vérifier les arguments qui les soutiennent et documenter deux décisions dans des ADR.
À produire
À la fin de l’exercice, conservez :
- une vue de contexte du système
- un inventaire des choix existants
- une fiche de stack indiquant le rôle de chaque technologie
- une liste séparant contraintes, critères, hypothèses et preuves
- un scénario de qualité mesurable
- une comparaison d’au moins deux options
- deux ADR
1. Délimiter le système
Dessinez une vue de contexte avec le système, les personnes qui l’utilisent et les systèmes externes. N’ajoutez pas encore les frameworks ni la base de données. Cette vue fixe ce qui appartient au projet et ce qui dépend d’un tiers.
2. Inventorier les choix existants
Listez les choix par niveau afin de ne pas mélanger une stratégie de déploiement avec une bibliothèque.
| Niveau | Exemples à chercher |
|---|---|
| système et déploiement | monolithe, applications séparées, hébergeur, base de données |
| rendu web et navigation | CSR, SSR, SSG, rendu hybride, SPA ou rechargement complet |
| organisation interne | couches, MVC, modules métier |
| interfaces | REST, format JSON, authentification, version des API |
| accès aux données | SQL direct, ORM, dépôt |
| dépendances | framework, bibliothèque HTTP, service tiers |
Pour chaque choix, notez son origine et la portée d’un changement.
| Choix | Origine | Parties concernées par un remplacement | Coût ou risque connu |
|---|---|---|---|
| SQLite | tutoriel initial | accès aux données, sauvegarde, déploiement | à mesurer |
Regroupez ensuite ces choix dans une fiche de stack. Précisez la technologie, sa version majeure, son rôle et les couches que la stack laisse ouvertes. Un acronyme comme MEAN ou TALL ne remplace pas cet inventaire.
3. Classer les arguments
Reprenez chaque justification et classez ses affirmations.
| Décision argumentée | Préférence assumée | Choix par défaut non réexaminé |
|---|---|---|
| des critères, un contexte et des conséquences existent | “j’aime bien”, “j’avais envie d’apprendre” | copié d’un tutoriel, installé par réflexe |
Puis séparez les informations utilisées pour décider.
| Information | Formulation du projet | Vérification prévue |
|---|---|---|
| Contrainte | ||
| Critère | ||
| Hypothèse | ||
| Preuve |
Une contrainte élimine une option. Un critère compare les options restantes. Une hypothèse demande une vérification. Une preuve cite une mesure, un document, un test ou une personne consultée.
4. Écrire un scénario de qualité
Choisissez une qualité affectée par l’architecture, par exemple la performance, la disponibilité, la sécurité ou la maintenabilité. Décrivez la source, le stimulus, l’environnement, la partie concernée, la réponse et sa mesure.
Source :
Stimulus :
Environnement :
Partie du système :
Réponse attendue :
Mesure :
Une mesure comme “moins de 300 ms” doit venir d’un besoin ou d’une expérience. Si elle n’est pas encore validée, marquez-la comme hypothèse et indiquez qui doit la confirmer.
5. Comparer les options
Retirez d’abord les options qui ne respectent pas les contraintes. Comparez ensuite au moins deux options sur les mêmes critères. Pour chaque note ou appréciation, ajoutez une source ou le statut “hypothèse”.
Si une migration est proposée, décomposez son estimation : conversion des données, adaptation du code, tests, déploiement et retour arrière. Un essai limité peut remplacer une estimation fondée uniquement sur l’intuition.
6. Rédiger deux ADR
- Confirmez un choix existant. Documentez son contexte, les alternatives considérées, les preuves disponibles, les hypothèses et au moins une conséquence négative.
- Proposez une alternative à un choix existant. Décrivez la migration, ses risques et les conditions qui feraient abandonner ou réexaminer la proposition.
7. Relire avec une autre personne
Faites relire vos ADR par une personne qui ne connaît pas les discussions à l’origine des décisions. Elle utilise cette grille :
| Point de contrôle | Validé | À revoir | Commentaire |
|---|---|---|---|
| Le périmètre, les personnes et les systèmes externes sont identifiés. | |||
| Le choix affecte la structure, une qualité, une dépendance, une interface ou le déploiement. | |||
| Les contraintes sont séparées des critères. | |||
| Les hypothèses sont nommées et accompagnées d’une vérification prévue. | |||
| Les preuves indiquent leur source ou leur mesure. | |||
| Au moins deux options crédibles sont comparées sur les mêmes critères. | |||
| Un scénario de qualité contient une réponse mesurable. | |||
| Les conséquences positives et négatives sont décrites. | |||
| Le coût de migration est décomposé ou testé. | |||
| Le seuil de réexamen peut être observé. | |||
| Les vues et l’ADR décrivent les mêmes frontières et dépendances. |
La revue est terminée lorsque la personne qui relit peut expliquer la décision, identifier les incertitudes restantes et proposer une correction sans reprendre la discussion orale qui l’a précédée.