Carnet, support de cours
Lire, comprendre et améliorer une codebase
On passe plus de temps à lire du code qu'à en écrire. Comprendre l'existant, le tien comme celui des autres, est une compétence centrale du métier, et on l'enseigne rarement. Ce cours part de là.
Sommaire
- Lire du codeRelire son vieux code
- Code smellsAstuces pratiques, Références
- RefactoriserQuand refactoriser
- Préparer et recevoir une reviewCôté auteur·rice : rendre sa PR relisible, Côté auteur·rice : recevoir une review
- Faire une revue de code constructiveCritères principaux, Conventional Comments
- Domain-Driven DesignNotions pour commencer en DDD, À quoi ça sert, Comment l’appliquer
- Annexes
- Catégories des variables
- VocabulaireClean code, Dette technique
- Principes et méthodos
Lire, comprendre et améliorer une codebase
On passe plus de temps à lire du code qu’à en écrire. Comprendre l’existant, le tien comme celui des autres, est une compétence centrale du métier, et on l’enseigne rarement. Ce cours part de là.
Le but est de rendre du code existant plus clair, plus sûr et plus simple à faire évoluer, pour toi comme pour les personnes qui passeront après. On commence par la lecture : entrer dans une codebase inconnue sans s’y perdre. On outille ensuite la compréhension : nommer, repérer les smells, partager un vocabulaire. Enfin on améliore : refactoriser par petits pas, faire et recevoir une review constructive.
Le fil rouge est la charge cognitive. Lire du code inconnu demande de tenir en tête la syntaxe, l’intention et l’exécution en même temps. Nommer ce qui bloque indique déjà quoi faire. Git te sert de filet : tant que tu commites, tu peux revenir à un état qui marchait.
Sections
Lire du code
Les développeur·ses passent près de 60 % de leur temps à comprendre du code, et bien moins à en écrire (Xia et al., “Measuring Program Comprehension”, IEEE Transactions on Software Engineering, 2018).
Dans The Programmer’s Brain (2021), Felienne Hermans distingue trois sources de confusion quand on lit du code :
- La syntaxe ou un concept inconnus : il manque une connaissance en mémoire à long terme.
- Ce que fait un bout de code : trop d’informations à tenir en même temps dans la mémoire à court terme.
- L’exécution globale : la mémoire de travail sature.
Nommer le type de confusion indique quoi faire : chercher dans la doc, noter sur papier, ou zoomer sur un bloc plus petit.
Relire son vieux code
Reprendre un projet écrit il y a quelques mois demande presque autant d’effort que lire le code de quelqu’un d’autre. Les détails, les évidences du moment et les raisons des décisions se sont effacés.
Pour relire ton code avec un regard critique, suis quatre étapes : cartographier, repérer les beacons, lire en surface et modifier pour comprendre.
Cartographier
Avant de chercher des problèmes, parcours les fichiers sans toucher au code, le temps de te souvenir. Pose-toi ces questions :
- Qu’est-ce que cette appli fait, en une phrase ?
- De quelle fonctionnalité étais-tu le plus fier·e ?
- Qu’est-ce que tu savais ne pas avoir eu le temps de faire correctement ?
La dernière question donne souvent la réponse la plus honnête. Elle mène aux smells à traiter en premier.
Ordre de lecture : arborescence → README → package.json et imports → point d’entrée.
Repérer les beacons
Les “beacons” (balises) sont des identifiants, noms de fonctions, de variables ou de classes, qui signalent l’intention du code. Ce sont les premières prises de sens dans une codebase inconnue.
Cherche les fonctions et variables dont le nom dit clairement ce qu’elles font. Ce sont tes points d’appui. Note ce que tu crois comprendre, tu vérifieras ensuite.
Cherche aussi les endroits où le nom ne dit rien : data, val, tmp, handleClick2. Ce sont tes premières cibles.
Lire en surface avant de lire en profondeur
Lis une fonction, note ce que tu penses qu’elle fait, passe à la suivante. Ne descends pas dans les dépendances avant d’avoir vu l’ensemble.
L’erreur classique : entrer dans une fonction, puis dans ses dépendances, puis dans les dépendances des dépendances, et se perdre.
Modifier pour mieux comprendre
Renomme une variable floue, simplifie une condition, supprime du code mort. Ces petits gestes aident à s’approprier le code autant qu’à l’améliorer. Si tu casses quelque chose, Git te ramène au dernier commit.
Smells
Tufano et al. ont étudié l’historique de 200 projets open source, soit environ 500 000 commits (“When and Why Your Code Starts to Smell Bad”, ICSE 2015). La plupart des smells sont présents dès la création du fichier. Ils n’apparaissent pas peu à peu. Le smell que tu trouves dans ton code vient souvent d’une décision de design prise le premier jour.
Une bonne partie des smells apparaît aussi juste avant une échéance. Le code écrit en fin de sprint, dans l’urgence, en accumule le plus.
Les débutant·es n’en introduisent pas le plus. Ce sont les propriétaires du fichier, surtout sous forte charge de travail et avant une échéance. L’expérience ne protège pas.
🟢 Les plus simples à repérer
| Smell | Signal | Action |
|---|---|---|
| Nom opaque | data, temp, x, btn2 | Renommer |
| Fonction trop longue | plus de 30 lignes, fait plusieurs choses | Extraire en sous-fonctions nommées |
| Code dupliqué | même bloc copié-collé 2 fois | Extraire en une fonction commune |
| Commentaire qui dit “quoi” | // boucle sur les items | Supprimer le commentaire et renommer pour que le code se lise seul |
| Variable morte | déclarée, jamais utilisée | Supprimer |
🟡 Demandent une lecture plus attentive
| Smell | Signal | Action |
|---|---|---|
| Nombre magique | if (x > 42) sans explication | Extraire en constante nommée |
| Condition négative complexe | if (!isNotValid && !isEmpty) | Inverser, simplifier |
| Trop de paramètres | function f(a, b, c, d, e) | Regrouper en objet, revoir la responsabilité |
| Pas de gestion d’erreur | fetch(url) sans .catch() | Ajouter try/catch ou .catch() |
🔴 Au niveau de l’architecture
| Smell | Signal |
|---|---|
| Fichier fourre-tout | un fichier qui fait réseau + DOM + logique métier |
| Accessibilité absente | <div onClick> au lieu de <button>, inputs sans label |
| Couplage fort | changer une fonction casse plein d’autres choses sans raison apparente |
Astuces pratiques
Le test de la phrase. Si tu ne peux pas expliquer ce que fait une fonction en une phrase, elle fait probablement plusieurs choses. Cherche où la couper.
Le test du renommage. Si trouver un nouveau nom pour une variable prend plus de 30 secondes, c’est souvent que la variable porte trop de responsabilités.
Lire à voix haute. Une ligne qui se lit naturellement à voix haute est en général claire. if (user.isActive()) se lit bien. if (!data[0].s !== false) ne se lit pas.
Le canard en caoutchouc. Explique un bout de code à voix haute, même à personne. L’endroit où tu butes est souvent l’endroit du problème.
Commencer par les smells verts. Renommer des variables et extraire les blocs dupliqués prend peu de temps et rend vite le code plus lisible. Les problèmes d’architecture viennent après, si le temps le permet.
Git comme filet de sécurité. Commite après chaque modification qui fonctionne, même petite. Fais un git stash avant d’essayer quelque chose d’incertain. Tant que ton travail est commité, tu peux y revenir.
# Exemples de messages explicites
git commit -m "renomme data en taskList, c'est un Container, pas une donnée générique"
git commit -m "extrait renderList, bloc dupliqué 3 fois dans handleClick, done et del"
git commit -m "remplace 42 par MAX_RETRY_COUNT, nombre magique sans contexte"
Références
- Felienne Hermans, The Programmer’s Brain (2021, Manning)
- Martin Fowler et Kent Beck, Refactoring: Improving the Design of Existing Code (1999, rééd. 2018)
- Michael Feathers, Working Effectively with Legacy Code (2004, Prentice Hall)
- Concept de code smell
- The .NET Core Podcast, épisode 96 avec Felienne Hermans
- Refactoring.Guru
Refactoriser
Quand refactoriser
Traduit et adapté de Refactoring.Guru.
La règle de trois
- La première fois que tu fais quelque chose, fais-le simplement fonctionner.
- La deuxième fois que tu fais quelque chose de similaire, tu râles intérieurement de devoir te répéter, mais tu fais quand même pareil.
- La troisième fois que tu fais encore la même chose, commence à refactoriser.
Quand tu ajoutes une fonctionnalité
Le refactoring t’aide à comprendre le code des autres. Si tu dois travailler avec du code sale écrit par quelqu’un d’autre, essaie d’abord de le refactoriser. Un code propre se comprend plus vite. Tu l’améliores pour toi et pour les personnes qui l’utiliseront après toi.
Le refactoring facilite aussi l’ajout de nouvelles fonctionnalités.
Quand tu corriges un bug
Les bugs dans le code se comportent comme les insectes dans la vraie vie : ils vivent dans les endroits les plus sombres et les plus sales du code. Nettoie ton code, et les erreurs finiront presque par se révéler d’elles-mêmes.
Les managers apprécient le refactoring proactif, parce qu’il évite d’avoir à prévoir des tâches de refactoring spécifiques plus tard.
Pendant une code review
La code review est parfois la dernière occasion de remettre le code au propre avant qu’il ne soit rendu public.
L’idéal est de faire ce type de review en binôme avec l’auteur ou l’autrice du code. Cela permet de corriger rapidement les problèmes simples et d’estimer le temps nécessaire pour traiter les plus complexes.
Faire une revue de code constructive
Conseils génériques
Ne pas tout réparer. Face à beaucoup de problèmes, choisis-en un, corrige-le, commite, recommence.
Cartographier d’abord. Lire le code dans le désordre, sans avoir vu la structure, t’embrouille pour rien.
Vérifier ses modifications. Avant chaque changement, demande-toi comment tu sauras que ça fonctionne toujours. Teste le cas d’usage à la main avant et après.
Préparer et recevoir une review
La qualité d’une review dépend aussi de la façon dont le changement est présenté. Ce travail revient à l’auteur·rice, avant le·la relecteur·rice.
Côté auteur·rice : rendre sa PR relisible
Une PR = une intention
Si tu ne peux pas résumer ta PR en une phrase, elle fait plusieurs choses : découpe-la. C’est le même test de la phrase que pour une fonction.
Une PR qui mélange “je corrige un bug”, “je renomme trois variables” et “j’ajoute une feature” est impossible à relire proprement : le·la relecteur·rice ne sait plus ce qui est le cœur du changement et ce qui est du bruit. Un diff qu’on peut tenir en tête d’un coup se relit bien. Un diff de 800 lignes se relit mal, ou pas du tout. Si ta PR dépasse ce que tu peux relire toi-même en une passe, elle est trop grosse.
Se relire avant de faire relire
Avant de demander une review, lis ton propre diff comme si c’était celui de quelqu’un d’autre. Tu attraperas la moitié des nitpick toi-même : le console.log oublié, la variable tmp jamais renommée, le commentaire mort. C’est l’exercice de “relire son vieux code”, mais à chaud.
Tu respectes ainsi le temps de l’autre, et la review ne porte pas un travail que tu pouvais faire seul·e.
Décrire la PR
Un titre clair, et une description qui répond à trois choses : ce que change la PR (en une phrase), pourquoi (le contexte, le ticket, la décision, car le pourquoi ne se lit pas dans le diff), et comment la tester (le cas d’usage concret à vérifier).
Template minimal :
## Quoi
Extrait la logique de formatage de prix dans `formatPrice()`.

## Pourquoi
Le bloc était dupliqué 3 fois (panier, facture, email). Ticket #142.

## Comment tester
Ajouter un article au panier, vérifier que le prix s'affiche formaté
à l'identique dans les trois écrans.
Baliser son propre code
Tu peux utiliser les conventional comments sur ta propre PR pour guider la relecture. C’est un usage du format qu’on oublie souvent :
thought: pas sûr de ce choix d'implémentation, un avis est bienvenunote: le TODO ici part dans un ticket séparé, pas dans cette PRquestion: est-ce que ce nom colle au vocabulaire métier ?
Tu diriges l’attention là où elle sert et tu réduis les allers-retours : le·la relecteur·rice n’a pas à deviner tes doutes.
Checklist avant d’ouvrir la PR
- [ ] Je peux résumer cette PR en une phrase.
- [ ] Je l’ai relue moi-même en entier.
- [ ] La description dit quoi / pourquoi / comment tester.
- [ ] J’ai balisé mes propres zones de doute.
- [ ] Pas de code mort, pas de
console.log, pas de secret en clair.
Côté auteur·rice : recevoir une review
Le code n’est pas toi
C’est le pendant de “on parle du code, pas de la personne”, dans l’autre sens : une remarque sur ton code n’est pas une remarque sur toi. La review sert à rendre le code plus clair et plus sûr, pas à établir qui a raison.
Si une remarque te pique, il y a souvent quelque chose à regarder, parfois dans le code, parfois dans sa formulation. Relis-la à froid avant de répondre.
Répondre selon le label
Le format conventional comments te dit quoi faire de chaque remarque :
| Label reçu | Ce que tu en fais |
|---|---|
issue (blocking) | À traiter avant merge, ou à argumenter explicitement si tu n’es pas d’accord. |
issue (non-blocking) / suggestion | Tu es libre de décliner, à condition de dire pourquoi. |
nitpick | Tu peux prendre ou laisser. Si tu laisses, un mot suffit. |
question | Tu réponds. Souvent la réponse mérite d’atterrir dans le code ou la doc, pas juste dans le fil. |
praise | Tu accuses réception. C’est de l’info utile : tu sais ce qui a marché. |
Clore les fils de discussion
Une remarque traitée se clôt : un commit qui répond, ou une réponse argumentée si tu déclines. Ne laisse pas un fil ouvert sans réponse : c’est ce qui fait traîner une review pendant des jours.
Décliner une suggestion est légitime : “je garde comme ça parce que X” est une réponse valable.
Faire une revue de code constructive
Une bonne review demande autant de compétences en communication qu’en technique.
Une revue de code ne sert pas à trouver des fautes. Elle sert à améliorer la qualité du logiciel à plusieurs et à partager la connaissance de la codebase.
Critères principaux
Lisibilité
Est-ce que je comprends vite ce que fait ce code ?
Vérifie que les noms sont explicites, que les fonctions sont courtes, que les commentaires sont utiles et que la structure suit une logique.
const d = get() contre const pendingInvoices = getPendingInvoices()
Cohérence
Est-ce que ce code ressemble au reste du projet ?
Vérifie les conventions de nommage, l’organisation des fichiers, le style (les linters aident), les patterns déjà utilisés et le vocabulaire métier.
Si toute l’app dit customer, on ne passe pas à client.
Maintenabilité
Dans six mois, sera-t-il facile de modifier ce code ?
Cherche la duplication, les smells, les responsabilités mélangées, les dépendances inutiles, les méthodes trop longues.
Sécurité
Cherche les injections SQL, les failles XSS, les secrets en clair, la gestion d’erreur manquante, par exemple un fetch(url) sans try { … } catch { … }.
Appuie-toi aussi sur le Top 10 de l’OWASP, sur la CI/CD et sur des outils comme Dependabot.
Rédiger une bonne review
Évite les formules comme “tu aurais dû”, “c’est pas top”, “ce n’est pas propre”. Préfère des phrases qui décrivent ce que tu observes ou ce que tu proposes :
- Je ne comprends pas ce que représente cette variable.
- Peut-on utiliser le vocabulaire métier ici ?
- Est-ce qu’on pourrait simplifier cette condition ?
- Je me demande si cette fonction n’a pas deux responsabilités.
On parle du code, pas de la personne. Attention aux sensibilités des autres et à ton propre ego.
Donner du contexte. Au lieu d’écrire renomme cette variable, explique : data semble représenter une liste de commandes en attente. Un nom plus précis aiderait les prochains lecteurs.
Féliciter aussi. “J’aime bien l’extraction de cette fonction”, “Le nom est beaucoup plus clair”, “Bonne gestion des erreurs”.
Conventional Comments
Une review est plus utile quand le lecteur comprend tout de suite l’intention du commentaire.
Les remarques n’ont pas toutes le même poids. Certaines doivent être corrigées vite, d’autres sont de simples suggestions. Sans indication, l’auteur·rice ne sait pas si la remarque est bloquante, une suggestion, une préférence ou une question.
Les Conventional Comments répondent à ce besoin avec un format standard pour les commentaires de review. Il se comprend vite et se retrouve par recherche.
# Format d'un conventional comment
<label> [decorations]: <subject>
[discussion]- label : le type de commentaire (obligatoire)
- decorations : des précisions entre parenthèses, séparées par des virgules (optionnel)
- subject : le message principal
- discussion : le contexte, la justification, le “pourquoi” (optionnel)
Les principaux labels
| Label | Usage |
|---|---|
praise: | Souligne un point positif. À utiliser sincèrement, pas par politesse. |
nitpick: | Préférence de style mineure, non bloquante par nature. |
suggestion: | Propose une amélioration. Précise le quoi et le pourquoi. |
issue: | Problème avéré (fonctionnel ou UX). Idéalement accompagné d’une suggestion. |
todo: | Changement nécessaire mais simple. |
question: | Doute pas encore tranché, invite à vérifier. |
thought: | Idée venue pendant la review, non bloquante mais utile. |
chore: | Tâche de process (lancer la CI, mettre à jour le changelog…). |
note: | Information à retenir, toujours non bloquante. |
Exemples
issue: Cette fonction ne valide jamais les entrées utilisateur.
issue: Cette requête SQL est vulnérable à une injection.
suggestion: On pourrait extraire cette logique dans une fonction formatPrice().
question: Pourquoi avoir choisi un tableau plutôt qu’une Map ici ?
praise: J’aime beaucoup l’utilisation du langage métier dans cette API.
nitpick: On pourrait harmoniser le nom avec le reste du projet (customer plutôt que client).
Les décorations
Les décorations précisent le poids d’une remarque :
(blocking): bloque l’acceptation tant que ce n’est pas résolu(non-blocking): n’empêche pas le merge(if-minor): à corriger seulement si le changement reste mineur.
Elles peuvent aussi indiquer le domaine concerné :
issue (security)
suggestion (readability)
question (domain)
nitpick (style)
praise (simplicity)
issue (accessibility)
suggestion (performance)
issue (maintainability)
Les deux se combinent, par exemple issue (security, blocking). Au-delà de deux décorations, le commentaire devient difficile à lire.
Pourquoi ce format
Un commentaire comme “ce n’est pas formulé correctement” laisse l’auteur·rice deviner s’il s’agit d’un point bloquant, d’une préférence ou d’une vraie erreur. Le label et le sujet sont obligatoires. Ils obligent à trancher l’intention avant d’écrire, ce qui réduit les allers-retours et les malentendus. Le format se cherche aussi avec grep : un script peut extraire tous les issue (blocking) d’une review (Aaron Bos).
Grille de review
| Question | Oui | Non | Commentaire |
|---|---|---|---|
| Les noms sont-ils explicites ? | □ | □ | |
| Le vocabulaire métier est-il cohérent ? | □ | □ | |
| Une fonction fait-elle une seule chose ? | □ | □ | |
| Y a-t-il du code dupliqué ? | □ | □ | |
| Les erreurs sont-elles gérées ? | □ | □ | |
| Les entrées sont-elles validées ? | □ | □ | |
| Le code est-il facile à modifier ? | □ | □ | |
| Les commentaires expliquent-ils pourquoi plutôt que quoi ? | □ | □ | |
| Le code respecte-t-il les conventions du projet ? | □ | □ | |
| Ai-je compris ce code sans demander d’explication ? | □ | □ |
Utilise cette grille pour relire un changement de code, seul ou avec une autre personne.
Une revue de code ne cherche pas à montrer qu’un développeur s’est trompé. Elle rend le code plus facile à comprendre, plus sûr et plus simple à faire évoluer, et l’équipe en sort avec une meilleure connaissance du projet.
DDD : Domain-Driven Design
Le Domain-Driven Design (DDD) est une approche de conception logicielle proposée par Eric Evans dans son livre Domain-Driven Design: Tackling Complexity in the Heart of Software (2003).
Evans publie gratuitement un résumé des notions du livre, sous licence Creative Commons : Domain-Driven Design Reference.
L’approche aligne le modèle d’un logiciel sur le métier qu’il sert. On ne conçoit pas l’application autour d’une base de données, d’un framework ou d’une API. On la construit autour de la façon dont les experts du métier pensent leur travail.
Notions pour commencer en DDD
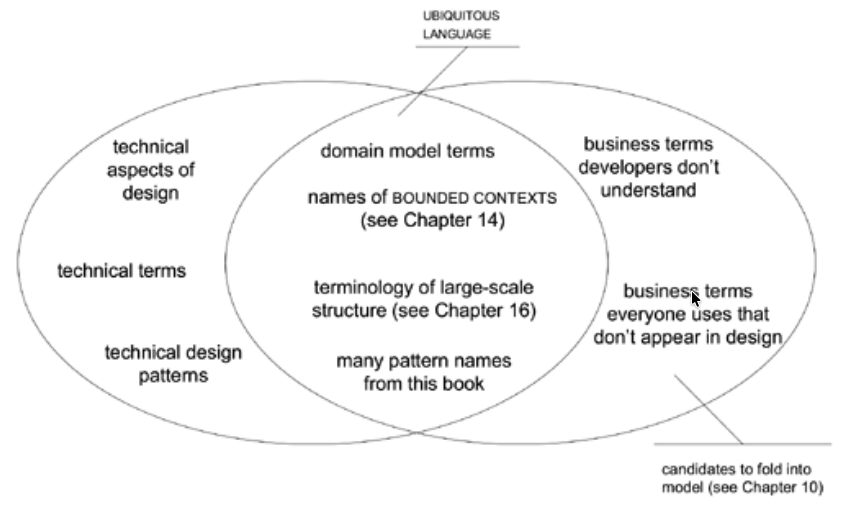
Langage ubiquitaire (ubiquitous language)
Le langage ubiquitaire est un vocabulaire structuré autour du modèle du domaine. Toute l’équipe l’utilise : développeurs, experts métier, designers, PO. On le retrouve dans le code, les tests et la documentation, comme dans les discussions, les tickets, les diagrammes et les commits.
Pour aller plus loin : The Coding Machine, “Ubiquitous language”.
Exemple : un projet de fret
// Avant
shipmentData
routingRows
customsFlag

// Après
cargo
routeSpecification
itinerary
Les noms “après” viennent du métier du fret : une cargaison, une spécification d’itinéraire, un itinéraire. Les noms “avant” décrivent des structures techniques.
Le métier parle en termes de besoins. Les devs traduisent en tables, services, booléens, payloads, endpoints. D’autres devs retraduisent ensuite. À chaque traduction, le sens se déforme.
À quoi ça sert
Sans langage commun, chaque groupe traduit pour l’autre. Dans le meilleur des cas, une ou deux personnes deviennent bilingues, et elles deviennent vite un goulot d’étranglement. Un grand projet ne peut pas reposer sur deux personnes pour traduire entre la technique et le métier.
Un langage fracturé produit des malentendus entre métier et devs, du code difficile à relire, des règles métier cachées dans des conditions techniques, des PR difficiles à relire, des bugs dus à des termes ambigus, et des refactorings qui cassent le modèle parce que personne ne sait ce qu’il représente.
Quand le langage change, le modèle change avec lui. Renommer shipmentData en itinerary précise le concept, pas seulement la variable.
Comment l’appliquer
Avant de coder ou de refactoriser, écoute les mots que les équipes emploient :
- Comment les utilisateurs appellent-ils ça ?
- Quel mot revient dans les échanges ?
- Ce mot a-t-il plusieurs sens ?
- Existe-t-il un terme plus précis ?
- Est-ce un concept métier ou un détail technique ?
Si le client dit :
On ne veut pas recalculer le trajet si l’itinéraire respecte encore les contraintes.
Les termes à retenir sont : itinéraire, contraintes, respecter, recalculer.
Dans le code, cela peut donner : Itinerary, RouteSpecification, routeSpecification.isSatisfiedBy(itinerary), RoutingService.
Tester à voix haute
Au lieu de dire : On supprime les lignes de la table shipment puis on relance le service.
Dis, avec le langage commun : Quand la Route Specification change, on vérifie si l’Itinerary la satisfait encore. Sinon, le Routing Service génère un nouvel Itinerary.
Le langage évolue. Si l’équipe trouve un meilleur mot, mets à jour tout ce qui utilise l’ancien : code, documentation, tests. Le langage reste ainsi aligné sur le métier.
Annexes
Catégories des variables
Le framework de Jorma Sajaniemi est un vocabulaire qui aide à comprendre le rôle d’une variable avant de la renommer.
| Rôle | Ce qu’elle fait |
|---|---|
| Fixed value | ne change pas après initialisation |
| Stepper | parcourt une liste de valeurs (i dans un for) |
| Flag | indique qu’un état est vrai ou faux |
| Walker | traverse une structure de données |
| Most-recent holder | retient la dernière valeur rencontrée |
| Most-wanted holder | retient la meilleure valeur trouvée |
| Gatherer | accumule et agrège des données |
| Container | contient plusieurs éléments |
| Follower | garde trace d’une valeur précédente |
| Organizer | stocke une version réorganisée des données (triée, inversée) |
| Temporary | garde une valeur le temps d’une opération |
Vocabulaire
Beacon (balise) : un élément du programme, souvent un nom, qui aide à comprendre ce que fait le code. Il sert à confirmer ou infirmer une hypothèse sur le code. La notion est plus précise que “cherche les noms explicites”.
Refactoring : modifier le code pour l’améliorer sans changer son comportement. L’appli doit fonctionner pareil avant et après chaque modification.
Dette technique : chaque raccourci pris en codant accumule une dette. Plus elle grossit, plus chaque modification devient lente et risquée. Refactoriser rembourse une partie de cette dette.
Code smell : un signal dans le code qui suggère un problème possible, à regarder de plus près.
Charge cognitive : lire du code inconnu est exigeant parce qu’il faut comprendre la syntaxe et l’intention en même temps. C’est normal que ce soit difficile.
Clean code
Traduit et adapté de Refactoring.Guru.
Le principal objectif du refactoring est de lutter contre la dette technique. Il transforme un code brouillon en un code propre et une conception simple.
Quelques caractéristiques du code propre :
Le code propre est évident pour les autres développeurs.
Le problème vient rarement d’algorithmes sophistiqués. Des variables mal nommées, des classes et méthodes surchargées, des nombres magiques rendent le code confus et difficile à suivre.
Le code propre ne contient pas de duplication.
Chaque fois que tu modifies du code dupliqué, tu dois répercuter le même changement partout ailleurs. Cela augmente la charge cognitive et ralentit la progression.
Le code propre contient un nombre minimal de classes et d’autres éléments mobiles.
Moins de code veut dire moins de choses à garder en tête, moins de maintenance et moins de bugs. Le code est un passif : garde-le court et simple.
Le code propre passe tous les tests.
Si seulement 95 % de tes tests passent, ton code a un problème. Si ta couverture de tests est de 0 %, tu ne sais même pas lequel.
Le code propre coûte moins cher à maintenir.
Dette technique
Traduit et adapté de Refactoring.Guru.
Presque personne n’écrit du code sale exprès. Le code propre se dégrade pourtant, pour des raisons listées plus bas.
La métaphore de la “dette technique” appliquée au code sale a été proposée à l’origine par Ward Cunningham.
Un prêt bancaire permet d’acheter plus tôt. En échange, tu rembourses le capital et des intérêts. Les intérêts peuvent s’accumuler au point de dépasser tes revenus et rendre le remboursement impossible.
Le code fonctionne pareil. Tu peux aller plus vite un temps en n’écrivant pas de tests pour de nouvelles fonctionnalités. Chaque jour, cette absence te ralentit un peu plus, jusqu’à ce que tu rembourses la dette en écrivant les tests.
Causes de la dette technique
Pression commerciale
Le contexte commercial force parfois à déployer des fonctionnalités inachevées. Des rustines apparaissent alors dans le code pour masquer les parties manquantes.
Manque de compréhension des conséquences de la dette technique
La direction ne voit pas toujours que la dette technique produit des “intérêts” : elle ralentit le développement à mesure qu’elle s’accumule. Obtenir du temps pour refactoriser devient alors difficile.
Couplage fort entre les composants
Le projet forme un bloc au lieu d’être découpé en modules. Toute modification d’une partie touche les autres. Le travail en équipe devient difficile, car on ne peut plus isoler le travail de chaque personne.
Manque de tests
Sans retour immédiat, on bricole des contournements rapides et risqués. Au pire, ces modifications partent en production sans aucun test. Un correctif anodin peut alors envoyer un e-mail de test à des milliers de clients, ou vider une base de données.
Manque de documentation
L’arrivée de nouvelles personnes prend plus de temps, et le développement peut s’arrêter si des personnes clés partent.
Manque d’interaction entre les membres de l’équipe
Si la connaissance ne circule pas, chacun travaille avec une vision dépassée du projet. Le problème s’aggrave quand les développeurs juniors sont mal accompagnés.
Développement simultané prolongé sur plusieurs branches
La dette s’accumule sur chaque branche et grossit encore au moment de la fusion. Plus les modifications restent isolées longtemps, plus la dette totale est lourde.
Refactoring retardé
Les exigences évoluent. Certaines parties du code deviennent obsolètes et doivent être repensées.
Pendant ce temps, l’équipe écrit chaque jour du code qui dépend de ces parties. Plus le refactoring attend, plus il y a de code à reprendre ensuite.
Manque de contrôle de conformité
Chaque personne écrit le code à sa façon, souvent comme sur son projet précédent.
Incompétence
Le développeur ne sait pas encore écrire ce code correctement.
Principes et méthodos
DRY (Don’t Repeat Yourself)
Chaque connaissance métier ou technique ne devrait être exprimée qu’à un seul endroit dans le code. La duplication augmente le risque d’incohérence : lorsqu’un comportement change, il faut penser à le modifier partout où il a été copié.
Le principe DRY est directement lié au code smell Code dupliqué. Le refactoring le plus courant consiste à extraire le comportement commun dans une fonction, une classe ou un composant réutilisable.
Attention : DRY ne signifie pas factoriser au moindre doublon. Attends plutôt la règle de trois : quand un même code apparaît trois fois et représente le même concept, extrais-le.
KISS (Keep It Simple, Stupid)
Choisis la solution la plus simple qui répond au besoin. Chaque niveau de complexité supplémentaire augmente le coût de lecture, de compréhension, de test et de maintenance.
La simplicité ne consiste pas à écrire le moins de code possible, mais à produire un code facile à comprendre et à faire évoluer.
Quelques indicateurs qu’un code est peut-être trop complexe :
- une fonction est difficile à résumer en une phrase ;
- plusieurs niveaux d’imbrication rendent la lecture difficile ;
- il faut relire plusieurs fois pour comprendre le comportement.
YAGNI (You Aren’t Gonna Need It)
N’implémente pas aujourd’hui des fonctionnalités dont tu pourrais avoir besoin demain. Développe ce qui répond au besoin actuel.
Le “au cas où” ajoute de la complexité, augmente le coût de maintenance et ralentit le développement, sans garantie que ce code serve un jour.
YAGNI n’interdit pas de penser à l’évolution du logiciel. Il demande de concevoir un code facile à faire évoluer au lieu de développer des fonctionnalités hypothétiques.
SOLID
SOLID regroupe cinq principes de conception orientée objet décrits par Robert C. Martin et popularisés sous l’acronyme SOLID par Michael Feathers.
Ce cours se concentre sur le Single Responsibility Principle (S), particulièrement utile dès les premiers projets. Les autres principes deviennent surtout pertinents lorsqu’on travaille avec des abstractions, des interfaces et des architectures orientées objet plus avancées.
S, Single Responsibility Principle
Une classe ou une fonction ne devrait avoir qu’une seule responsabilité, c’est-à-dire une seule raison d’évoluer.
Quand une unité de code remplit plusieurs rôles, une modification pour l’un peut casser l’autre, alors qu’ils n’ont rien à voir. Séparer les responsabilités rend le code plus lisible, plus testable et plus facile à maintenir.
| Lettre | Principe | En une phrase |
|---|---|---|
| O | Open/Closed | Une entité devrait être extensible sans qu’on ait à modifier son code existant. |
| L | Liskov Substitution | Un sous-type doit pouvoir remplacer son type parent sans casser le comportement attendu. |
| I | Interface Segregation | Mieux vaut plusieurs interfaces spécifiques qu’une seule interface fourre-tout. |
| D | Dependency Inversion | Le code métier dépend d’abstractions, pas d’implémentations concrètes. |
Source : Robert C. Martin, “Design Principles and Design Patterns” (2000).
Références
- Andy Hunt, Dave Thomas, The Pragmatic Programmer (1999) : DRY, orthogonalité.
- Martin Fowler, Kent Beck, Refactoring (1999, rééd. 2018) : règle de trois, catalogue de refactorings.
- Robert C. Martin, Design Principles and Design Patterns (2000) : les cinq principes SOLID.
- Kent Beck, Extreme Programming Explained (1999) : YAGNI, simplicité incrémentale.
- Martin Fowler, article “Yagni”.