Carnet, support de cours
SEO, GEO et GEA
Comment faire connaître un site quand on cherche une salle d'escalade sur Google ou qu'on demande conseil à une IA ? Ce cours présente les bases du référencement et les corrections qu'un développeur peut apporter à une page.
Sommaire
- Comment fonctionne un moteur de rechercheDe la découverte d’une page à son affichage, Ce qui influence le classement, Reconnaître les éléments d’une page de résultats, Quelques idées reçues sur le référencement
- Le SEO techniqueQue mettre dans le head d’une page, Organiser le contenu avec des balises HTML, Comprendre les réponses du serveur, Distinguer robots.txt et noindex, Vérifier ce qu’un robot peut lire sans JavaScript, Rendre les pages lisibles et rapides à charger sur mobile, Décrire la salle avec des données structurées, Contrôler une page avec Lighthouse et suivre le site avec Search Console
- Le contenu : répondre aux recherches des visiteursComprendre le besoin derrière une recherche, Employer les mots des visiteurs, Donner la réponse avant les détails, Faire des liens entre les pages utiles, Garder les informations à jour, Faire connaître la salle sur d’autres sites, Suivre les résultats dans Search Console
- Le GEO : être cité par une IAComment une IA trouve ses sources, Comparer les réponses et vérifier les informations, Publier des informations que les robots peuvent lire, Autoriser la recherche sans autoriser l’entraînement, Aucune citation par une IA n’est garantie, Observer les citations et les visites
- SEA et GEA : les annonces dans la rechercheReconnaître une annonce dans Google, Distinguer une annonce d’une source citée par une IA, Préparer la page vers laquelle mène l’annonce, Choisir entre contenu et publicité
- Atelier : corriger la page de Prise d'Air1. Observer une recherche, 2. Corriger la page, Le travail à rendre, Corrigé, Pour aller plus loin
- Lexique
- Annexe : cheat-sheet SEOContenu et confiance, HTML et métadonnées, Exploration et indexation, Images, mobile et performance, Après publication, Quel outil pour quel contrôle ?
SEO, GEO et GEA
Comment faire connaître un site quand on cherche une salle d’escalade sur Google ou qu’on demande conseil à une IA ? Ce cours présente les bases du référencement et les corrections qu’un développeur peut apporter à une page.
Vous apprendrez à vérifier ce qu’un robot peut lire, à rédiger des informations utiles et à corriger une page HTML. L’atelier permet de mettre ces notions en pratique.
Le référencement dans Google et dans les réponses des IA
Le SEO (Search Engine Optimization), ou référencement naturel, consiste à améliorer un site pour qu’il apparaisse dans les résultats gratuits d’un moteur de recherche. Google affiche un titre, un lien et un extrait de la page.
Le GEO (Generative Engine Optimization) consiste à préparer les pages d’un site pour que des outils comme ChatGPT, Gemini ou Perplexity les utilisent comme sources et les citent dans leurs réponses. La personne peut alors obtenir une réponse à sa question sans visiter le site.
La publicité prend aussi plusieurs formes : le SEA (Search Engine Advertising) désigne les annonces dans les moteurs de recherche, par exemple via Google Ads, tandis que le GEA (Generative Engine Advertising) désigne celles qui s’affichent avec les réponses d’une IA. Dans ce dernier cas, il faut distinguer l’annonce payante des sources citées dans la réponse.
Le SEO et le GEO reposent sur des bases communes : les robots doivent accéder à la page, comprendre son contenu et y trouver une réponse utile. Ce travail se partage entre le développeur, qui s’occupe du HTML, des liens et du chargement, et l’équipe qui gère le site, qui fournit les tarifs, les horaires et les autres informations à publier. Les avis et les liens depuis d’autres sites contribuent aussi à faire connaître l’établissement.
Une salle d’escalade à Lyon comme exemple
Le cours prend pour exemple Prise d’Air, une salle d’escalade de bloc fictive située à Lyon 7e, dont le site est prisedair.example. Le bloc se pratique sans corde, sur des murs d’environ 4 m, au-dessus de tapis.
La salle souhaite accueillir davantage de débutants, dont les questions guideront les exemples du cours : “C’est quoi le bloc ?”, “Combien coûte une séance ?” ou “Quelle salle choisir pour débuter à Lyon ?”
Lire le cours et corriger une page
- Comprendre les moteurs de recherche : comment une page entre dans les résultats.
- Préparer le HTML pour le référencement : titres, liens, robots et affichage sur mobile.
- Répondre aux recherches des visiteurs : choisir les informations et les organiser.
- Comprendre les citations des IA : comment les outils trouvent et reprennent des sources.
- Distinguer référencement et publicité : reconnaître une annonce et préparer la page qu’elle ouvre.
- Corriger la page de Prise d’Air : observer, repérer les problèmes et vérifier les corrections.
En annexe, le lexique explique les termes techniques et la cheat-sheet SEO rassemble les vérifications avant et après publication.
Ce travail rejoint le titre professionnel Développeur web et web mobile, RNCP37674, qui prévoit de publier des sites et de les rendre visibles sur les moteurs de recherche.
Comment fonctionne un moteur de recherche
Quand vous lancez une recherche, Google consulte son index, une base de données constituée à partir des pages que ses robots ont visitées, sans parcourir à nouveau tout le web. Pour apparaître dans les résultats naturels, une page doit donc d’abord entrer dans cet index.
De la découverte d’une page à son affichage
Google découvre les adresses grâce aux liens et aux sitemaps, puis son robot, Googlebot, télécharge les pages : c’est l’exploration. Vient ensuite l’indexation, au cours de laquelle Google analyse leur contenu et décide lesquelles conserver dans son index. C’est parmi ces pages qu’il sélectionne et classe les résultats d’une recherche.
flowchart TB
    accTitle: Les étapes de la recherche Google
    accDescr: Google découvre la page, la lit, l'indexe et la classe.
    D["Découverte : Google trouve l'adresse"] --> C["Exploration : Googlebot télécharge la page"]
    C --> R["Rendu : Google exécute le JavaScript"]
    R --> I["Indexation : Google analyse et conserve la page"]
    I --> S["Recherche : Google sélectionne et classe les pages"]
Plusieurs obstacles peuvent intervenir au cours de ces étapes : une erreur du serveur peut empêcher le téléchargement, tandis qu’une balise noindex demande de ne pas indexer la page. Même sur une page accessible, un texte qui n’apparaît qu’après un clic risque de ne pas être lu. Le chapitre technique explique comment repérer ces problèmes.
Même si son code respecte les consignes, rien ne garantit qu’une page sera explorée, indexée ou affichée, comme le précise Google dans sa présentation du fonctionnement de la recherche.
Ce qui influence le classement
Google cherche des pages qui répondent au besoin de la personne. Pour “escalade lyon débutant”, la localisation, les cours proposés et les informations pratiques comptent davantage qu’une longue histoire de l’escalade.
Dans sa présentation du classement des résultats, Google explique tenir compte du sens de la recherche, de la pertinence du contenu, de sa fiabilité, du confort d’utilisation et du contexte, comme le lieu ou la langue. Les liens venant d’autres sites peuvent également l’aider à évaluer une page, mais la liste complète des signaux et leur poids ne sont pas publics.
Reconnaître les éléments d’une page de résultats
La page de résultats, appelée SERP (Search Engine Results Page) dans les outils SEO, rassemble plusieurs types de réponses dont la présence varie selon la recherche.
| Élément | Comment le reconnaître |
|---|---|
| Annonce | Un résultat avec une mention comme “Sponsorisé” |
| Résultat naturel | Un titre, une adresse et un extrait de la page, sans mention publicitaire |
| Résultats locaux, ou pack local | Une carte et des fiches d’établissements avec adresse, horaires et avis |
| Aperçu IA | Une réponse rédigée par IA avec des liens vers des sources |
| Autres questions | Des questions proches de la recherche |
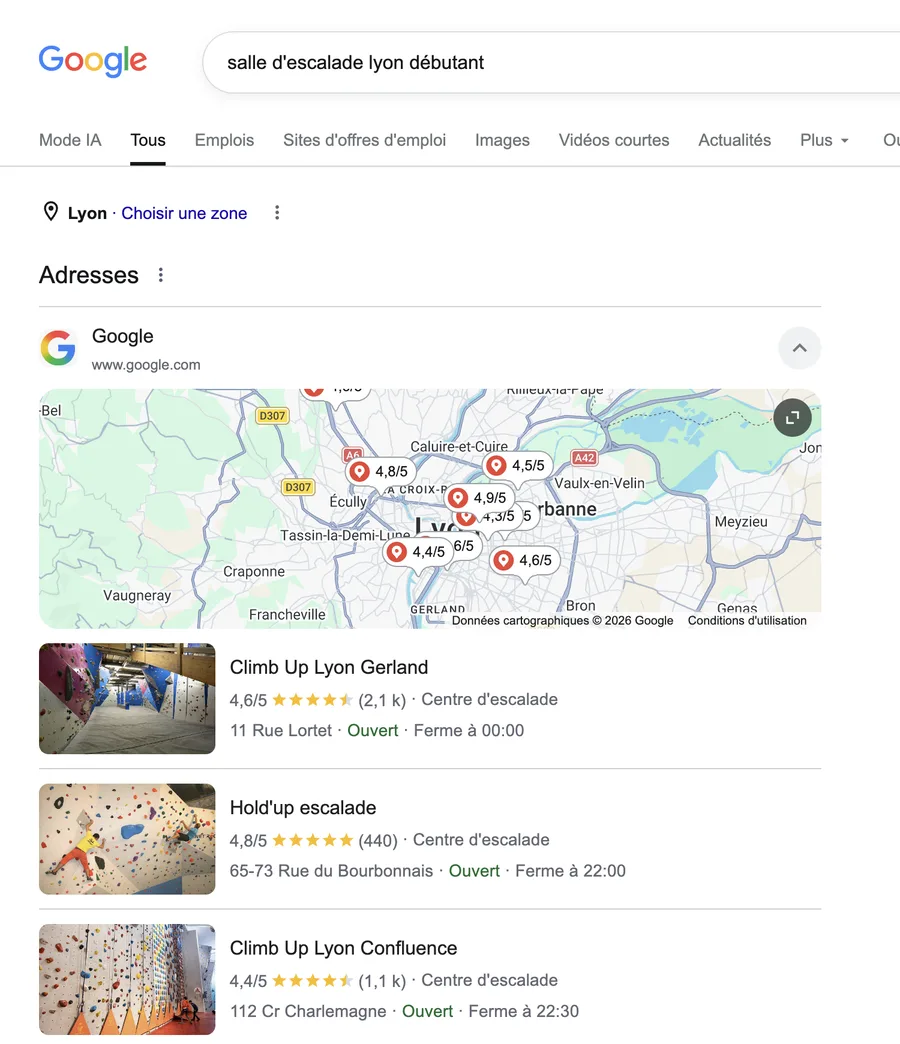
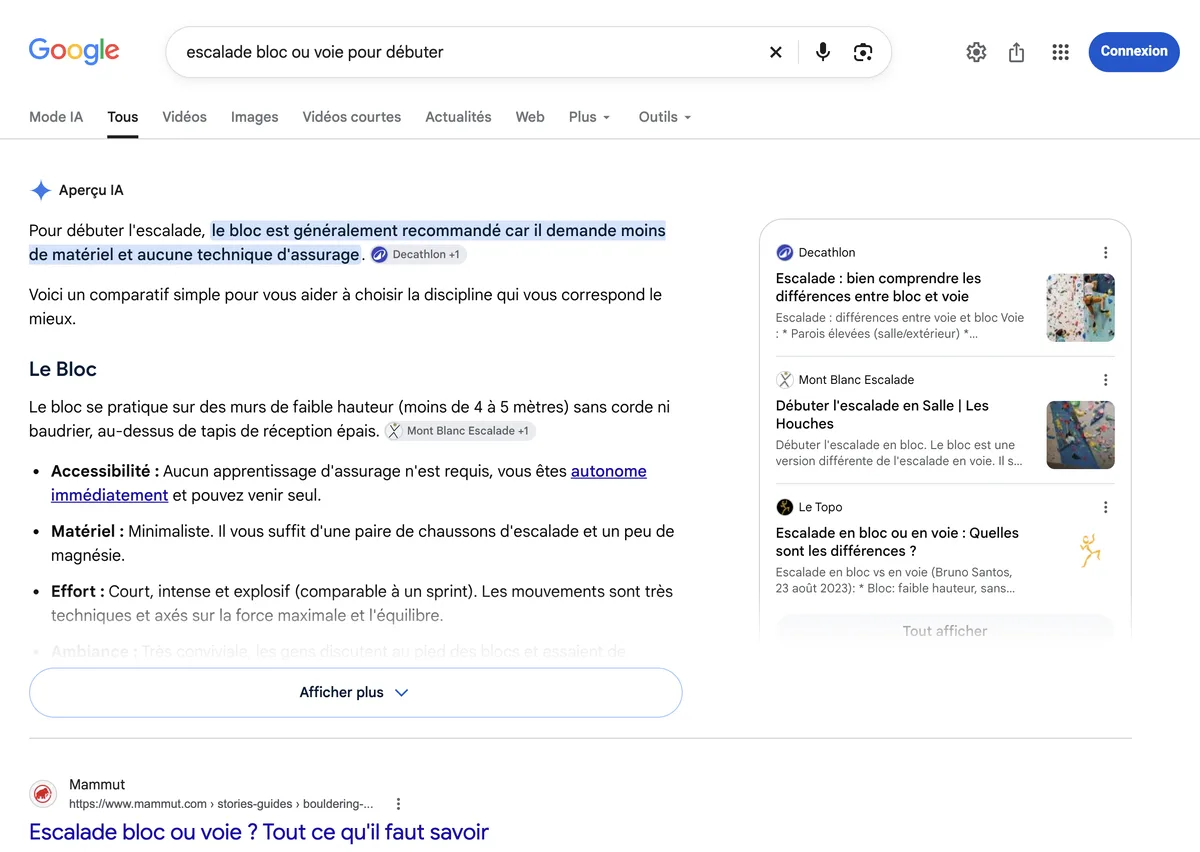
Les sources de cet Aperçu IA comprennent une marque de matériel et des sites spécialisés. Une page qui répond à une question de débutant peut donc servir de source, même si elle ne vient pas d’un grand site généraliste. Les réponses et les sources peuvent changer d’une recherche à l’autre.
Quelques idées reçues sur le référencement
Payer une annonce Google Ads permet d’acheter un emplacement publicitaire, sans améliorer le classement naturel du site.
Google précise que la balise meta keywords n’aide pas au classement et qu’il n’existe pas de longueur de texte idéale. Ses conseils sur le contenu utile invitent à fournir les informations nécessaires pour répondre à la recherche.
L’expression “être premier sur Google” n’a de sens que pour une recherche et un contexte donnés : vérifiez donc les résultats pour plusieurs formulations. Une fois le site en ligne, Search Console permet de suivre sa visibilité.
Le SEO technique
Le SEO technique permet aux robots d’accéder aux pages et d’en lire le contenu. Pour commencer, vérifiez le HTML, les liens et l’affichage sur téléphone.
Vous retrouverez des pratiques du cours d’accessibilité : des titres bien organisés, des liens compréhensibles et des alternatives aux images.
Que mettre dans le head d’une page
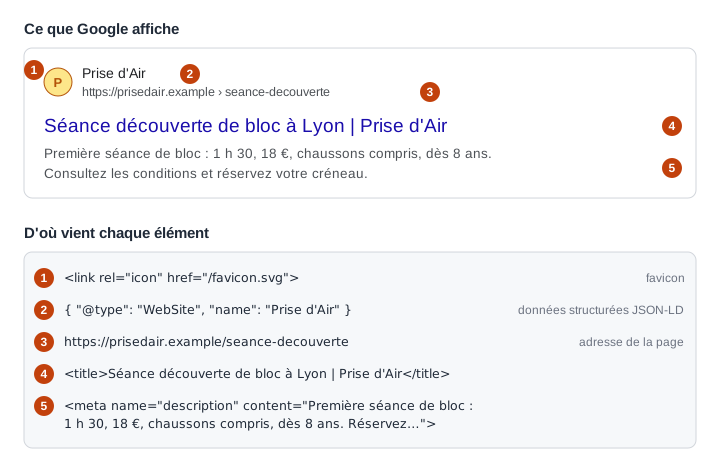
Le head contient notamment le titre de l’onglet et une description que Google peut reprendre dans ses résultats.
<!doctype html>
<html lang="fr">
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Séance découverte de bloc à Lyon | Prise d'Air</title>
  <meta name="description" content="Première séance de bloc à Lyon 7e : 1 h 30, 18 €, chaussons compris, dès 8 ans. Découvrez les conditions et réservez votre créneau.">
  <link rel="canonical" href="https://prisedair.example/seance-decouverte">
  <link rel="icon" href="/favicon.svg">
</head>
Donnez à chaque page un title unique, descriptif et concis, comme “Tarifs de l’escalade de bloc à Lyon | Prise d’Air”, qui renseigne davantage le visiteur que “Tarifs” seul. Complétez-le par une meta description propre à cette page, qui résume le contenu en une ou deux phrases.
Dans cet exemple, lang="fr" indique la langue du document, tandis que la balise viewport permet un affichage adapté au téléphone. Si le même contenu existe à plusieurs URL, le lien canonical en indique l’adresse de référence.
Google peut reprendre le titre et la description ou choisir d’autres textes dans la page, comme l’explique sa documentation sur les liens de titre et les extraits. La meta description ne détermine pas le classement, mais elle peut aider la personne à décider de cliquer.
Choisir une URL canonique cohérente
Si /seance-decouverte et /seance-decouverte?utm_source=lettre affichent le même contenu, leur canonical peut désigner https://prisedair.example/seance-decouverte. Cette adresse doit aussi être celle utilisée dans les liens internes et le sitemap. Une page sans doublon peut indiquer sa propre URL.
Le canonical est un signal, pas une obligation pour Google. Les redirections et le sitemap contribuent aussi à son choix. Ne faites pas pointer toutes les pages vers l’accueil : la page de référence doit proposer un contenu identique ou très proche. Google, choix d’une URL canonique.
Préparer les aperçus de partage
Les balises Open Graph décrivent le titre, le texte et l’image proposés lorsqu’un lien est partagé sur un service compatible. Ajoutez-les dans le head si vous voulez maîtriser cet aperçu. Les cartes X, encore appelées Twitter Cards, utilisent notamment twitter:card.
<meta property="og:type" content="website">
<meta property="og:title" content="Séance découverte de bloc à Lyon | Prise d'Air">
<meta property="og:description" content="1 h 30 de bloc à Lyon 7e, 18 €, chaussons compris. Consultez les conditions et les créneaux.">
<meta property="og:url" content="https://prisedair.example/seance-decouverte">
<meta property="og:image" content="https://prisedair.example/images/seance-decouverte.jpg">
<meta property="og:image:alt" content="Le mur de bloc de la salle Prise d'Air">
<meta name="twitter:card" content="summary_large_image">
Remplacez les adresses fictives par celles de la page et d’une image publique réellement disponible. Ces balises servent à la présentation du partage, sans garantir un gain de classement dans Google. Elles complètent le title et la meta description. Protocole Open Graph.
Organiser le contenu avec des balises HTML
Agrandir le texte d’un div ne suffit pas à en faire un titre dans la structure HTML. Utilisez les balises qui correspondent au contenu : h1 pour le titre principal, h2 pour les sections et a pour les liens.
<!-- Exemple à corriger -->
<div class="gros">Bienvenue !</div>
<span onclick="location.href='/tarifs'">Tarifs</span>
<a href="/tarifs">ici</a>
<!-- Exemple corrigé -->
<h1>Salle d'escalade de bloc à Lyon 7e</h1>
<h2>Tarifs et réservations</h2>
<a href="/tarifs">Voir les tarifs</a>
<p>Séance découverte : 1 h 30, 18 €, chaussons compris.</p>Utilisez aussi header, nav, main et footer pour identifier les zones de la page, et article si le contenu forme un ensemble autonome. Les niveaux h1, h2 et h3 décrivent une hiérarchie, leur apparence se règle en CSS. Pour ce cours, utilisez un h1 principal. Le nombre de h1 ne suffit pas à juger la qualité du référencement : vérifiez surtout que la structure aide à comprendre la page.
Google découvre les autres pages grâce aux liens <a href>, dont le texte doit annoncer la destination : “Voir les tarifs” plutôt que “ici”. Sa documentation sur les liens explorables détaille ces recommandations.
Écrivez les prix, les horaires et l’adresse en texte HTML pour qu’ils soient accessibles sans dépendre d’une image ou d’un clic. Les images informatives doivent aussi avoir un alt qui transmet l’information utile, tandis que les images décoratives reçoivent un alt="".
Choisir des adresses lisibles
Préférez /seance-decouverte à une adresse difficile à comprendre comme /index.php?id=42&cat=7. Utilisez des minuscules et des tirets entre les mots. Gardez les URL stables : ne renommez pas une page déjà publiée pour y ajouter quelques mots-clés.
Comprendre les réponses du serveur
Quand vous ouvrez une adresse, votre navigateur demande une page au serveur qui héberge le site. Ils échangent selon un ensemble de règles appelé HTTP. Le serveur renvoie le contenu demandé, s’il le trouve, et un code de statut HTTP : un nombre qui indique le résultat de la demande.
Par exemple, le code 200 signifie que la demande a réussi. Les codes 301 et 404 correspondent à deux autres situations, utiles à connaître quand vous modifiez un site.
Une page change d’adresse : la redirection 301
Supposons que la page /decouverte devienne /seance-decouverte. Des visiteurs peuvent encore utiliser l’ancienne adresse depuis leurs favoris ou un lien partagé.
Configurez une redirection 301 sur le serveur pour indiquer que la page a déménagé définitivement et fournir sa nouvelle adresse. Le navigateur l’ouvre automatiquement, ce qui permet au visiteur d’arriver sur la bonne page même avec l’ancien lien. Les moteurs de recherche peuvent eux aussi prendre en compte ce changement.
Mettez également à jour les liens de votre site pour qu’ils pointent directement vers /seance-decouverte.
Une page est introuvable : le code 404
Si une page a été supprimée sans page équivalente pour la remplacer, le serveur doit renvoyer le code 404, qui signifie “aucune page trouvée à cette adresse”. Une faute de frappe dans l’adresse peut produire la même réponse.
Vous pouvez afficher un message utile, par exemple “Cette page n’existe plus”, avec un lien vers l’accueil ou les activités. Le serveur doit tout de même renvoyer le code 404 : écrire “page introuvable” dans une page envoyée avec le code 200 donnerait une information trompeuse aux robots.
Si un contenu équivalent existe à une nouvelle adresse, utilisez plutôt une redirection 301 vers cette page. Évitez de rediriger toutes les pages supprimées vers l’accueil, où le visiteur risque de ne pas retrouver ce qu’il cherchait.
Sécuriser la connexion avec HTTPS
HTTPS est la version sécurisée de HTTP. Les échanges entre le navigateur et le serveur sont chiffrés, ce qui protège notamment les informations envoyées dans un formulaire pendant leur trajet.
L’adresse commence alors par https://. Pour l’activer, configurez un certificat TLS auprès de votre hébergeur, puis redirigez les adresses http:// vers leur version https://. Beaucoup d’hébergeurs proposent cette configuration dans leur interface.
HTTPS protège la connexion, sans garantir la fiabilité du contenu du site.
Pour approfondir : MDN, code 301, code 404 et HTTPS.
Distinguer robots.txt et noindex
Ces deux instructions interviennent à des étapes différentes :
| Instruction | Effet |
|---|---|
robots.txt | Demande aux robots de ne pas explorer certaines adresses |
noindex | Demande de ne pas conserver une page dans l’index |
Le fichier robots.txt se place à la racine du site. Dans cet exemple, les robots peuvent visiter les pages publiques, mais pas la recherche interne ni l’espace membre.
User-agent: *
Disallow: /recherche
Disallow: /compte/

Sitemap: https://prisedair.example/sitemap.xml
Une page bloquée dans robots.txt peut encore apparaître dans Google si d’autres sites pointent vers elle. Pour demander son retrait de l’index, ajoutez cette balise dans son head et laissez le robot explorer la page :
<meta name="robots" content="noindex">Le serveur peut aussi envoyer une instruction noindex dans l’en-tête HTTP X-Robots-Tag. Vérifiez cet en-tête dans l’onglet Réseau des DevTools, même si aucune balise noindex n’apparaît dans le HTML. Google, directives robots.
Comme le rappelle Google dans sa présentation de robots.txt, ce fichier ne protège pas les données privées : un espace membre doit exiger une connexion pour en contrôler l’accès.
Aider les robots à trouver les pages avec un sitemap
Un sitemap est un fichier XML qui liste les pages à faire découvrir. Il aide le moteur à trouver leurs adresses, sans garantir leur indexation.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://prisedair.example/</loc>
  </url>
  <url>
    <loc>https://prisedair.example/seance-decouverte</loc>
  </url>
</urlset>
Les outils de création de sites peuvent générer ce fichier, dans lequel le champ lastmod permet d’indiquer la date à laquelle un contenu a réellement changé.
Vérifier ce qu’un robot peut lire sans JavaScript
Google peut exécuter le JavaScript, mais tous les robots ne le font pas. Pour les informations publiques à référencer, préférez un HTML qui contient déjà le texte.
Le rendu côté serveur (SSR) et la génération statique (SSG) produisent ce HTML avant de l’envoyer au navigateur. Avec le rendu côté client (CSR), le navigateur construit le contenu en exécutant le JavaScript.
Dans la page de Prise d’Air à corriger, le code source (Ctrl+U, ou Cmd+Option+U sur Mac) contient un <div id="infos"></div> vide. Le prix “18 €” figure dans un script, pas dans le contenu HTML.
Après un clic sur “Afficher les infos”, l’onglet Éléments des DevTools montre le prix et les conditions dans <div id="infos">. Un robot sans JavaScript ne voit pas cet ajout. Placez ces informations directement dans le HTML pour les rendre lisibles dès le chargement.
Rendre les pages lisibles et rapides à charger sur mobile
Google utilise la version mobile des pages pour l’indexation. Vérifiez que le contenu reste disponible sur téléphone et que la page ne déborde pas horizontalement.
Privilégiez les formats WebP ou AVIF, qui permettent souvent de réduire le poids des images. Pour celles qui se trouvent hors du viewport au chargement de la page, utilisez loading="lazy" afin de différer leur téléchargement. Ne l’appliquez pas à l’image principale si elle est visible dès l’ouverture. Indiquez aussi width et height pour que le navigateur réserve la place des images et évite les décalages de mise en page.
<img src="mur-principal.avif" width="1200" height="800"
     alt="Le mur principal de Prise d'Air, avec ses blocs de couleur">

<img src="vestiaires.webp" width="600" height="400" loading="lazy"
     alt="Les vestiaires">
Choisissez des noms de fichiers descriptifs, comme mur-bloc-lyon.webp plutôt que IMG_8392.webp. Le alt décrit l’information utile dans le contexte de la page, sans accumuler des mots-clés. Servez une image adaptée à sa taille d’affichage, avec srcset et sizes si plusieurs tailles sont disponibles. Google, bonnes pratiques pour les images.
Les Core Web Vitals mesurent la vitesse d’affichage du contenu principal (LCP), la réactivité (INP) et la stabilité de la mise en page (CLS). Ces mesures, décrites dans la documentation de Google, vous aideront dans l’atelier à repérer une image lourde, du JavaScript qui ralentit la page ou des éléments qui se déplacent pendant le chargement.
| Mesure | Seuil considéré comme bon |
|---|---|
| LCP, affichage du contenu principal | ≤ 2,5 s |
| INP, délai de réponse aux interactions | ≤ 200 ms |
| CLS, décalages de mise en page | ≤ 0,1 |
Ces seuils s’évaluent au 75e percentile des visites, séparément sur mobile et ordinateur : au moins 75 % des mesures doivent atteindre le seuil. Un test Lighthouse au chargement ne mesure pas l’INP des visiteurs, car il ne reproduit pas leurs interactions. Consultez les données de terrain de PageSpeed Insights ou de Search Console lorsqu’elles sont disponibles. web.dev, Core Web Vitals.
Commencez par les ressources qui ralentissent réellement la page : réduisez le JavaScript et les scripts tiers inutiles, limitez les polices et leurs variantes, et évitez de bloquer le premier affichage avec du CSS superflu. Configurez le cache HTTP des fichiers statiques. Un CDN, qui distribue les fichiers depuis plusieurs serveurs, peut aider si la distance avec les visiteurs ralentit leur chargement. Les conseils de web.dev permettent de choisir les corrections à partir des mesures.
Ces indicateurs participent à l’expérience de page prise en compte par Google. De bons scores ne garantissent pas une bonne position et ne remplacent pas un contenu pertinent. Google, Core Web Vitals et recherche.
Décrire la salle avec des données structurées
En lisant “Prise d’Air, 12 rue Imaginaire, Lyon”, un visiteur reconnaît le nom de la salle et son adresse. Les données structurées rendent ces informations explicites pour les moteurs grâce à des champs comme name pour le nom du lieu et address pour son adresse. Le vocabulaire schema.org définit ces champs et les types de lieux qu’ils peuvent décrire.
Ce balisage aide Google à identifier ce que décrit la page et peut, pour les types pris en charge, la rendre éligible à un résultat enrichi : une recette peut par exemple apparaître avec son temps de cuisson. Google précise toutefois dans sa présentation des données structurées que cet affichage n’est jamais garanti.
Ajoutez des données structurées lorsqu’un type correspond au contenu de la page et que les informations sont déjà présentes en HTML pour les visiteurs, conformément aux règles de Google sur le contenu balisé. Pour la page qui présente Prise d’Air, le type SportsActivityLocation convient à un lieu d’activité sportive. Si le nom ou l’adresse change, pensez à mettre à jour le texte visible et le balisage.
Google recommande d’écrire ces données en JSON-LD, sous la forme d’un objet JSON placé dans <script type="application/ld+json">. Cette balise contient uniquement des données : elle n’exécute pas de JavaScript et n’affiche pas de texte sur la page.
Exemple JSON-LD pour Prise d'Air
@type indique le type de lieu, name son nom et address son adresse.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "SportsActivityLocation",
  "name": "Prise d'Air",
  "url": "https://prisedair.example/",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "12 rue Imaginaire",
    "postalCode": "69007",
    "addressLocality": "Lyon",
    "addressCountry": "FR"
  }
}
</script>
Vérifiez ce bloc avec le validateur schema.org. Le test des résultats enrichis de Google vérifie les types pris en charge par Google, sans promettre leur affichage dans les résultats.
Le type dépend de ce que décrit la page : Organization pour une organisation, Article pour un article, Event pour un événement, Product pour un produit ou BreadcrumbList pour un fil d’Ariane. Un type valide dans schema.org n’est pas forcément pris en charge comme résultat enrichi par Google. Choisissez le balisage adapté au contenu, sans attendre une hausse automatique du classement.
Contrôler une page avec Lighthouse et suivre le site avec Search Console
Lighthouse, dans les DevTools, effectue des contrôles automatiques de performance, d’accessibilité et de SEO, y compris sur une page servie en local. Ses résultats donnent des pistes, mais ne remplacent pas un audit d’accessibilité : même un score de 100 en accessibilité ne garantit pas que la page soit utilisable au clavier ou avec un lecteur d’écran. Il faut aussi vérifier les parcours et le contenu à la main. Chrome, score d’accessibilité Lighthouse.
Ses mesures de performance viennent d’un test réalisé dans des conditions simulées. Elles aident à repérer des lenteurs, mais ne suffisent pas à décrire ce que vivent les visiteurs sur leurs appareils et leurs connexions. Pour un site publié, comparez-les à des mesures recueillies auprès des visiteurs. web.dev, mesures en laboratoire et sur le terrain.
Un bon score SEO ne garantit pas non plus une bonne place dans Google : Lighthouse ne juge pas si le texte répond aux recherches des visiteurs.
Search Console sert à suivre un site publié : pages indexées, erreurs, recherches et clics. Il faut prouver que vous gérez le site pour accéder à ses rapports.
Pour un site que vous gérez, suivez ces étapes après publication :
- Ajoutez le site dans Search Console et validez sa propriété, par exemple avec un enregistrement DNS pour une propriété de type Domaine.
- Envoyez l’adresse de
sitemap.xmldans le rapport Sitemaps et vérifiez qu’il est lisible. Listez les URL canoniques des pages à indexer, sans pages supprimées ni pagesnoindex. - Inspectez l’URL d’une page importante. Vérifiez l’état d’indexation et l’URL canonique choisie par Google. Le test en direct vérifie l’accès actuel, sans prouver que la page est déjà indexée.
- Consultez les rapports d’indexation, les Core Web Vitals et les rapports de résultats enrichis disponibles pour le site. Un petit site peut manquer de données de terrain.
- Suivez les requêtes, impressions, clics et CTR dans le rapport Performances, détaillé au chapitre sur le contenu.
Search Console et l’envoi du sitemap ne sont pas obligatoires pour apparaître dans Google. Ils facilitent le diagnostic et le suivi. Google, démarrer avec Search Console.
Le contenu : répondre aux recherches des visiteurs
Une personne qui cherche le prix d’une séance attend un prix. Si la page ne donne que des formules comme “une expérience unique”, elle ne répond pas à sa question.
Comprendre le besoin derrière une recherche
L’intention de recherche est ce que la personne cherche à faire : comprendre, trouver un lieu, comparer ou réserver.
| Recherche | Besoin | Page utile |
|---|---|---|
| “c’est quoi l’escalade de bloc” | Comprendre une activité | Une explication avec des photos |
| “prise d’air lyon horaires” | Trouver une information sur la salle | Les horaires et l’adresse |
| “salle de bloc lyon débutant” | Choisir une salle | Une présentation des séances et des conditions d’accueil |
| “réserver séance escalade lyon” | Réserver | Une page avec les créneaux et le prix |
Tapez la recherche dans Google et observez les résultats. Des articles explicatifs, une carte ou des pages de réservation vous donnent des indices sur le besoin que le moteur a retenu.
Avant de rédiger, associez chaque page à une intention principale. Plusieurs formulations proches peuvent mener à la même page : inutile de créer une page par variante de mot-clé.
| URL de Prise d’Air | Intention principale |
|---|---|
/ | Trouver une salle de bloc à Lyon 7e |
/seance-decouverte | Préparer et réserver une première séance |
/tarifs | Connaître les prix des séances et abonnements |
/conseils/premiere-seance | Savoir quoi apporter et comment se déroule la découverte |
Employer les mots des visiteurs
Les professionnels et les visiteurs n’emploient pas toujours les mêmes mots : la salle peut parler de “séance d’initiation”, alors qu’un débutant tape “première fois escalade”. En vous limitant au vocabulaire de la salle, vous risquez de moins bien répondre à cette recherche et de ne pas y apparaître. Reprenez donc aussi les formulations des visiteurs dans vos textes.
Pour trouver ces formulations, appuyez-vous sur :
- les suggestions que Google affiche pendant la saisie
- le bloc “Autres questions posées” dans la page de résultats
- les questions que les clients posent à l’accueil, au téléphone ou par mail
Search Console montrera aussi les recherches qui ont fait apparaître le site, une fois celui-ci publié.
Un petit site a souvent plus de chances d’apparaître pour une recherche précise comme “escalade bloc Lyon 7 débutant” que pour un terme très général comme “escalade”, car le besoin est mieux défini. Ces recherches précises font souvent partie de la longue traîne, qui désigne l’ensemble des nombreuses recherches peu fréquentes.
Donner la réponse avant les détails
Choisissez un sujet principal par page, annoncez-le dans le title et le h1, puis donnez la réponse dans les premières lignes. Développez ensuite les questions associées dans les sections, par exemple le prix, le matériel à apporter ou les conditions de réservation.
| Texte vague | Texte utile au débutant |
|---|---|
| “Venez vivre une expérience unique dans notre salle. Notre équipe passionnée vous attend dans un cadre exceptionnel.” | “La séance découverte dure 1 h 30 et coûte 18 €, chaussons compris. Un moniteur vous apprend à tomber sur les tapis, puis vous essayez des blocs faciles. La séance est ouverte dès 8 ans, avec un adulte jusqu’à 14 ans.” |
Un moteur ou une IA peut aussi reprendre ces informations dans un extrait.
Pour un conseil technique, indiquez qui l’a écrit et sur quelle expérience il s’appuie. Un article signé par une monitrice, accompagné de photos de la salle et d’explications concrètes, donne au lecteur des éléments pour évaluer sa fiabilité. Cette démarche rejoint les recommandations de Google sur le contenu utile et fiable.
Le sujet peut apparaître naturellement dans le title, le h1 et le texte. Il n’y a ni densité de mots-clés à atteindre ni nombre de mots idéal : arrêtez-vous lorsque la page répond au besoin.
Identifier l’auteur et montrer son expérience
Les repères E-E-A-T désignent l’expérience, l’expertise, l’autorité et la fiabilité. Google précise qu’ils ne constituent pas un facteur de classement unique. Pour le lecteur, ils se traduisent par des éléments vérifiables : qui écrit, sur quelle expérience, avec quelles sources ? Google, contenu utile et E-E-A-T.
Pour Prise d’Air, une page « L’équipe » peut présenter les moniteurs, leurs qualifications réelles et un moyen de contact. Un article peut renvoyer vers la personne qui l’a rédigé. Un compte rendu d’atelier peut préciser le public accueilli, l’objectif, le déroulement, les difficultés observées et les enseignements, avec des photos autorisées. Ces détails apportent davantage au lecteur qu’une galerie sans explication.
Des articles comme « Que faut-il apporter pour sa première séance ? » ou « Comment se déroule une initiation au bloc ? » répondent aux questions de l’accueil. Rédigez-les à partir de l’expérience de l’équipe et vérifiez les conseils avant publication.
Faire des liens entre les pages utiles
La page “Débuter le bloc à Lyon” peut présenter l’activité et renvoyer vers les tarifs, le matériel et la réservation. Ces liens aident le visiteur à poursuivre sa démarche et le robot à découvrir les pages.
flowchart LR
    accTitle: Des liens utiles depuis la page pour débutants
    accDescr: La présentation du bloc renvoie vers les tarifs, le matériel et la réservation.
    P["Débuter le bloc à Lyon"] --> T["Consulter les tarifs"]
    P --> M["Préparer sa première séance"]
    P --> R["Réserver une séance découverte"]
Écrivez “Voir les tarifs” ou “Préparer sa première séance” plutôt que “En savoir plus”. Si deux pages répètent les mêmes informations, demandez-vous si une seule page serait plus facile à consulter et à maintenir.
Garder les informations à jour
Il n’est pas nécessaire de publier un article par semaine pour être bien référencé : Google recommande dans ses conseils sur le contenu de privilégier l’utilité des pages plutôt que de chercher à faire paraître le site plus actif. De même, changer une date sans modifier le contenu ne constitue pas une mise à jour.
Pour Prise d’Air, commencez par vérifier les prix, les horaires de vacances et les conditions des séances, puis ajoutez des articles s’ils répondent à des questions encore sans réponse sur le site. Un calendrier de publication peut aider à organiser ce travail, mais il ne remplace pas la vérification des informations.
Une IA peut vous aider à préparer un plan ou à reformuler un texte, à condition de vérifier les faits et d’y apporter les informations propres à la salle. Produire beaucoup de pages génériques qui n’aident pas les visiteurs peut enfreindre les règles de Google contre le spam.
Faire connaître la salle sur d’autres sites
Un lien depuis un autre site vers le vôtre s’appelle un backlink. Un club universitaire, un office de tourisme ou un article de presse locale peut faire découvrir Prise d’Air et envoyer des visiteurs vers son site.
L’intérêt d’un backlink dépend notamment de la pertinence du site qui le publie : multiplier les liens dans des annuaires sans rapport avec l’activité n’apporte pas la même valeur qu’une mention sur un site lié à l’escalade ou à la vie locale. Acheter des liens pour manipuler le classement enfreint par ailleurs les règles de Google.
Pour les recherches locales, complétez la fiche d’établissement Google avec la catégorie, l’adresse, les horaires, les photos et le lien vers le site, en veillant à garder les mêmes coordonnées sur les différents supports. Vous pouvez aussi répondre aux avis et demander des retours sincères aux clients.
Suivre les résultats dans Search Console
Le rapport Performances indique quelles recherches font apparaître le site et lesquelles amènent des visites.
| Mesure | Ce qu’elle indique |
|---|---|
| Impressions | Combien de fois un résultat du site a été affiché |
| Clics | Combien de fois une personne a cliqué vers le site |
| CTR, ou taux de clics | La part des impressions qui ont produit un clic |
| Position moyenne | La position moyenne du premier résultat du site |
Beaucoup d’impressions et peu de clics peuvent signaler un titre peu clair, mais aussi s’expliquer par une réponse déjà visible dans les résultats. Avant de modifier la page, examinez donc la recherche concernée et comparez des périodes assez longues pour observer une tendance.
Le GEO : être cité par une IA
Une IA peut s’appuyer sur plusieurs pages pour rédiger une réponse et citer certaines d’entre elles. Le GEO consiste à préparer un site pour qu’il puisse faire partie de ces sources, sans permettre de choisir ce que l’IA écrira.
Comment une IA trouve ses sources
Une IA peut répondre à partir de ce qu’elle a appris pendant son entraînement. Dans ce cas, elle ne consulte pas forcément de page et ses informations peuvent être anciennes.
Lorsqu’elle utilise la recherche web, l’IA cherche des pages et en lit des passages sur lesquels elle s’appuie pour rédiger sa réponse. Cette méthode, souvent appelée RAG, permet d’associer la réponse aux pages consultées et d’y renvoyer par des liens.
Une question comme “Quelle salle de bloc pour débuter à Lyon ?” peut entraîner plusieurs recherches : salles à Lyon, accueil des débutants, prix et horaires. Google décrit ce fonctionnement dans sa documentation sur les fonctionnalités d’IA.
flowchart TB
    accTitle: Une réponse d'IA avec des sources
    accDescr: L'outil cherche des pages, puis rédige une réponse qui les cite.
    Q["Question : où débuter le bloc à Lyon ?"] --> F["Recherches : salles, prix, accueil des débutants"]
    F --> P["Lecture de pages trouvées sur le web"]
    P --> R["Réponse rédigée avec des liens vers des sources"]
Votre page peut être utile en fournissant un prix, un horaire ou une condition d’accès, même si elle ne répond pas à l’ensemble de la question.
Comparer les réponses et vérifier les informations
Voici les réponses du Mode IA de Google et de ChatGPT à une même question posée le 1er octobre 2026 : “Quelle salle d’escalade pour débuter à Lyon, pas trop chère, un samedi ?”
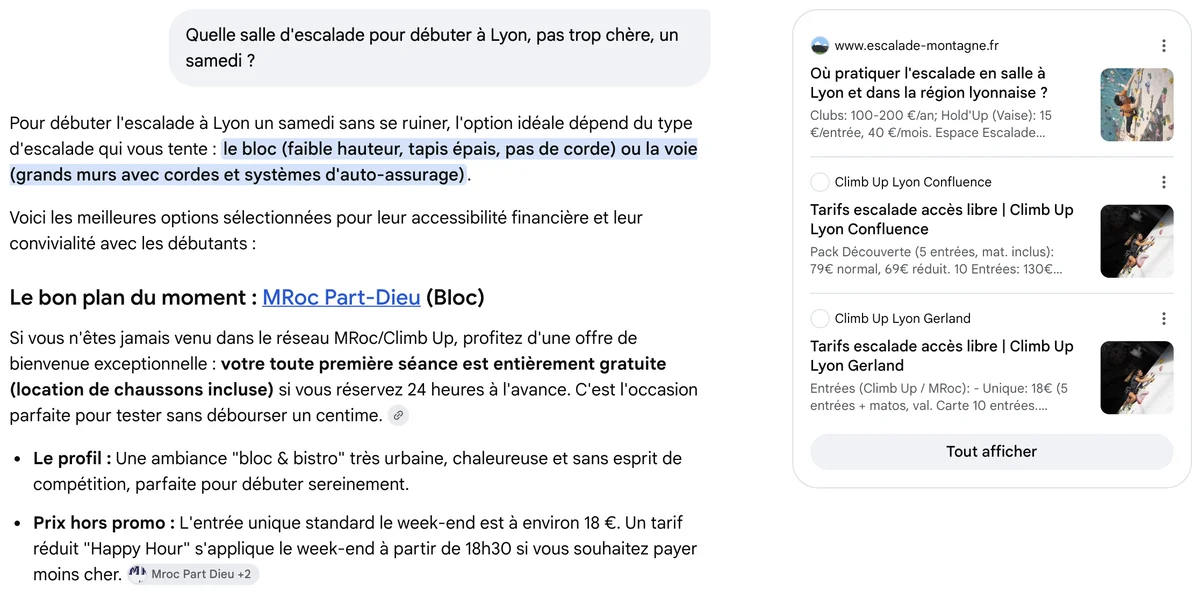
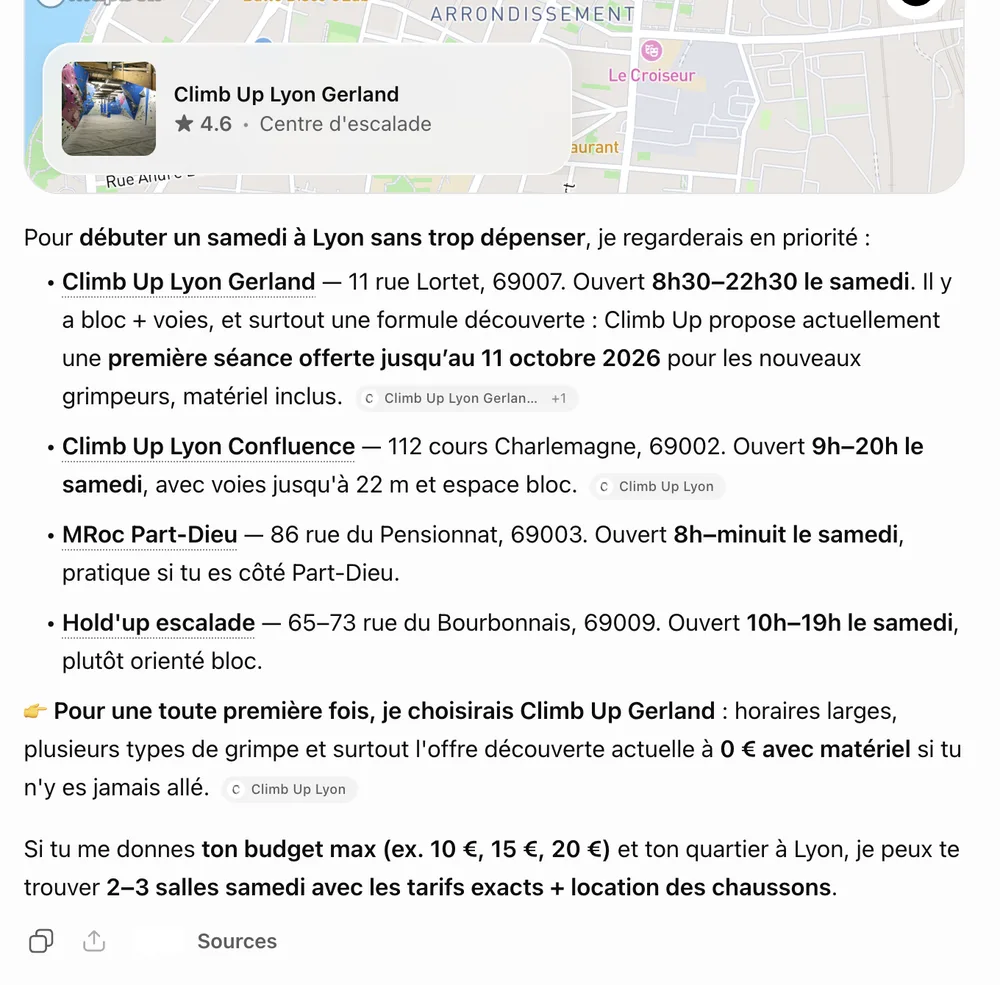
Les deux outils reprennent des informations publiées par les salles et par un site spécialisé, sans forcément choisir les mêmes sources. Leurs réponses peuvent aussi changer si vous posez une deuxième fois la même question.
Un lien placé après une phrase ne garantit pas que la page source confirme ce qui est écrit : l’outil peut mélanger les prix de deux salles, reprendre une offre terminée ou donner les horaires de la semaine au lieu de ceux du samedi. Il faut donc ouvrir les sources pour vérifier ces informations.
Publier des informations que les robots peuvent lire
Commencez par les bases du SEO : une page accessible, des liens et du texte dans le HTML. Pour les Aperçus IA et le Mode IA, les conditions d’affichage de Google exigent une page indexée qui peut être affichée avec un extrait, sans demander de balisage spécial pour l’IA.
Publiez ensuite les informations de la salle avec assez de contexte pour qu’elles soient comprises seules :
| Formulation vague | Information utilisable |
|---|---|
| “Nos tarifs sont très accessibles.” | “La séance découverte coûte 18 €, chaussons compris.” |
| “Ouvert tard en semaine !” | “La salle Prise d’Air est ouverte du lundi au vendredi de 12 h à 23 h.” |
Vérifiez les informations publiées et mettez-les à jour lorsqu’elles changent.
Autoriser la recherche sans autoriser l’entraînement
Les entreprises d’IA utilisent des robots pour des tâches différentes. Chez OpenAI, OAI-SearchBot sert à la recherche de sources dans ChatGPT, tandis que GPTBot collecte du contenu qui peut servir à l’entraînement.
Les deux réglages sont indépendants. Voici un exemple qui laisse la recherche accéder aux pages publiques, tout en refusant la collecte par GPTBot :
User-agent: *
Disallow: /compte/

User-agent: GPTBot
Disallow: /

Sitemap: https://prisedair.example/sitemap.xml
Dans cet exemple, GPTBot suit les règles du groupe qui lui est réservé, tandis que les autres robots suivent celles du groupe *. Autoriser l’exploration dans ce fichier ne suffit toutefois pas : le serveur doit aussi laisser passer les requêtes, comme l’explique la documentation des robots d’OpenAI. Même lorsque l’accès est possible, rien ne garantit que la salle sera citée.
Chez Google, Googlebot explore les pages pour la recherche, y compris pour les réponses IA, tandis que Google-Extended contrôle certains usages liés à Gemini, indépendamment du référencement dans Google. Avant de modifier ces règles, consultez la documentation du fournisseur sur les contrôles des contenus et le rôle de Google-Extended.
Aucune citation par une IA n’est garantie
Aucun réglage ne garantit “la première place dans ChatGPT”, puisque le choix des sources dépend de la question et du fonctionnement de l’outil.
Les bonnes pratiques de Google n’exigent ni fichier llms.txt ni données structurées spéciales pour apparaître dans ses réponses IA : le travail consiste à garder des pages utiles et lisibles.
La proposition llms.txt décrit un fichier Markdown qui présente un site et ses ressources aux outils d’IA. Il ne remplace pas les règles de robots.txt.
N’ajoutez pas de texte caché qui ordonne à une IA de recommander la salle. Cette tentative de manipulation, appelée injection de prompt, peut détourner une réponse et tromper la personne qui la lit.
Observer les citations et les visites
Pour un premier contrôle, posez une question liée à l’activité et notez les sources citées, puis répétez la recherche avant d’en tirer une conclusion. Une seule réponse ne suffit pas à mesurer la visibilité d’un site.
Sur un site publié, l’outil de statistiques peut montrer des visites provenant de services comme ChatGPT ou Perplexity, même si leur origine n’est pas toujours transmise. Une citation peut aussi faire connaître la salle sans produire de clic : distinguez donc les citations du site dans les réponses des visites qu’elles lui apportent.
SEA et GEA : les annonces dans la recherche
Une salle peut payer pour afficher une annonce quand quelqu’un cherche une activité. Le SEA concerne les moteurs de recherche. Le GEA concerne les annonces affichées avec les réponses des IA.
Pour un développeur junior, il s’agit surtout de reconnaître ces annonces et de préparer la page qu’elles ouvrent.
Reconnaître une annonce dans Google
Avec Google Ads, l’annonceur choisit des mots-clés, rédige une annonce et fixe un budget. L’affichage dépend notamment de l’enchère et de la qualité de l’annonce et de sa page de destination. L’annonceur paie souvent lorsqu’une personne clique : c’est le coût par clic, ou CPC. Google Ads, classement des annonces.
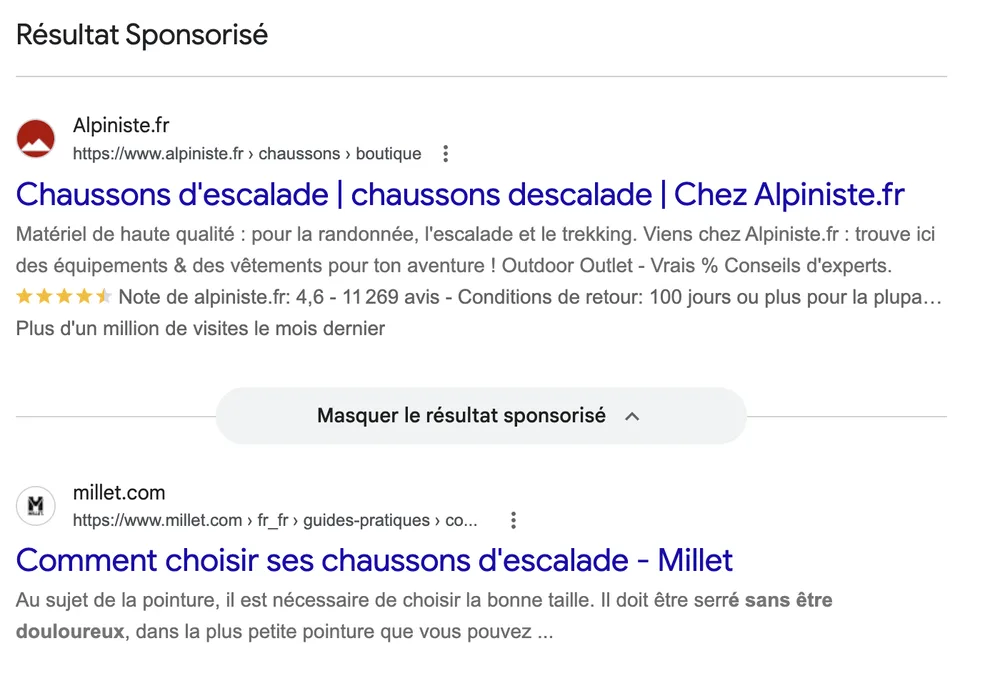
Les résultats locaux peuvent aussi contenir des annonces. Cherchez la mention publicitaire plutôt que de vous fier à la position dans la liste.
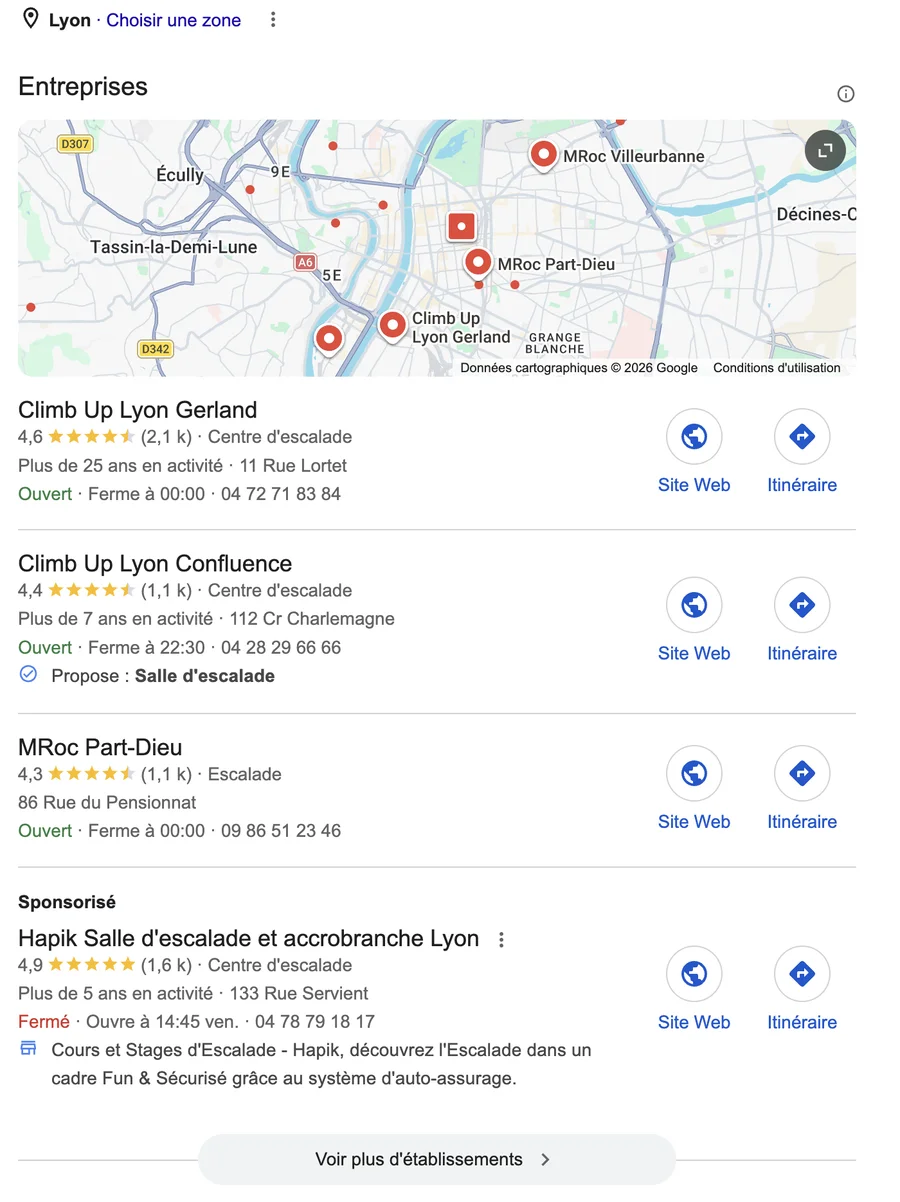
Pour Prise d’Air, une annonce “Découvrez le bloc à Lyon” pourrait mener à la page de la séance découverte. Cette page doit présenter le prix et la réservation annoncés. Payer cette annonce n’améliore pas le classement naturel du site.
Distinguer une annonce d’une source citée par une IA
Une source citée fournit des informations pour la réponse. Une annonce est un emplacement acheté par une entreprise. Sa présence ne prouve pas que l’IA a recommandé cette entreprise dans son texte.
OpenAI indique que les annonces de ChatGPT sont séparées des réponses et ne les influencent pas. Elles peuvent apparaître sous une réponse. Leur disponibilité dépend notamment du pays et du compte. OpenAI, annonces dans ChatGPT.
Préparer la page vers laquelle mène l’annonce
La page d’arrivée, ou landing page, doit répondre à la promesse de l’annonce. Si celle-ci propose une séance pour débutants, affichez le prix, les conditions et un lien de réservation compréhensible. Vérifiez aussi le chargement et l’affichage sur téléphone.
L’annonceur cherche généralement une conversion : une réservation, une inscription ou un achat.
Les plateformes peuvent fournir des scripts pour mesurer ces actions. Les traceurs publicitaires nécessitent le consentement préalable du visiteur. Refuser doit être aussi simple qu’accepter. Le cours RGPD détaille ce fonctionnement. CNIL, cookies et autres traceurs.
Choisir entre contenu et publicité
Le SEO et le GEO demandent du travail sur le site, sans payer chaque clic. Ils ne garantissent ni position ni citation. Le SEA et le GEA demandent un budget publicitaire et dépendent des emplacements proposés par la plateforme.
La publicité peut amener des visiteurs, mais elle ne corrige pas une page confuse. Pour Prise d’Air, vérifiez les tarifs, les horaires et le parcours de réservation avant de financer une campagne.
Exercice complémentaire : vérifier la promesse d'une annonce
Pour une annonce “Séance découverte à 18 €”, esquissez la page d’arrivée avec ses informations et son bouton de réservation.
Atelier : corriger la page de Prise d’Air
La page d’accueil de Prise d’Air, une salle d’escalade fictive à Lyon, contient des erreurs volontaires. Corrigez-la pour qu’elle soit bien référencée et accessible.
Il vous faut un éditeur de code, un navigateur avec Lighthouse, comme Chrome ou Helium, et une IA avec recherche web.
1. Observer une recherche
Cherchez “salle d’escalade lyon débutant” sur Google. Posez ensuite la question “Quelle salle d’escalade pour débuter à Lyon un samedi ?” à une IA avec recherche web.
Notez ce que Google affiche en premier (annonce, carte, Aperçu IA ou résultat naturel) et les sources citées par l’IA. Vérifiez un prix ou un horaire sur le site d’une de ces sources.
2. Corriger la page
Télécharger la page à corriger
Corrigez le HTML pour que :
- Google comprenne ce que propose la page et puisse l’indexer,
- un visiteur trouve l’adresse, les horaires et les conditions de la séance découverte sans cliquer, sur ordinateur comme sur téléphone,
- une personne au clavier ou avec un lecteur d’écran puisse lire la page et suivre ses liens.
Gardez les informations de la salle : séance de 1 h 30 à 18 €, chaussons compris, dès 8 ans, avec un adulte jusqu’à 14 ans. Les autres pages du site n’existent pas. Faites pointer les liens vers des sections de la page, par exemple href="#tarifs".
Lighthouse analyse seulement les pages servies en HTTP. Ouvrez la page avec un serveur local, par exemple Live Server dans VS Code, npx serve ou python3 -m http.server. Lancez Lighthouse avant et après vos corrections, sur Mobile, avec les catégories SEO et Accessibilité. Lighthouse ne repère pas tout : lisez aussi le code et affichez la page à 360 px de large.
Le travail à rendre
Rendez votre page corrigée et un document de notes, par exemple un Google Doc, avec :
- ce que vous avez observé sur Google et dans la réponse de l’IA,
- les scores Lighthouse SEO et Accessibilité avant et après,
- les problèmes trouvés, avec leur correction en une phrase.
Exemple : “Le menu utilise des span avec onclick. Je les remplace par des liens <a href> pour que les robots et le clavier puissent les suivre.”
Corrigé
Après votre correction
- La langue est déclarée en anglais et la balise
viewportmanque. - Le titre “Accueil” est vague et la meta description manque.
- La balise
noindexdemande de ne pas indexer la page.meta keywordsn’aide pas Google. - Le titre principal est un
divet les niveaux de titres sont mal organisés. - Les éléments du menu sont des
spancliquables. Tab ne les atteint pas et les robots ne suivent pas leurs adresses. Le lien “Réserver” mène à#. - Les images n’ont pas d’alternative textuelle. L’adresse et les horaires sont uniquement dans une image.
- Le texte d’accueil ne donne pas d’information sur la séance ou le lieu.
- Les tarifs affichent une ancienne date et leur lien s’appelle “ici”. Le PDF n’existe pas : écrivez le tarif dans la page.
- Les conditions de la séance apparaissent seulement après un clic, en JavaScript.
- Un texte caché répète des mots-clés. La largeur fixe de 960 px fait déborder la page sur mobile.
Pour aller plus loin
Ces exercices sont facultatifs.
Écrire un robots.txt
À partir de l’exemple du chapitre technique, écrivez un fichier qui laisse explorer les pages publiques et bloque /recherche et /compte/. Indiquez ensuite si vous souhaitez autoriser GPTBot, en vous aidant du chapitre GEO.
Préparer un article pour débutants
Trouvez une question dans les suggestions de Google. Proposez un titre, deux ou trois sections et un court paragraphe qui donne la réponse. Ajoutez un lien vers une page utile de Prise d’Air. Si vous utilisez une IA, indiquez ce que vous avez vérifié.
Décrire la salle en JSON-LD
Adaptez l’exemple de données structurées à votre page. Vérifiez-le avec le validateur schema.org.
Lexique
Les termes anglais sont ceux de la documentation et des outils.
| Terme | Sens | Chapitre |
|---|---|---|
| 200 | Code de statut HTTP indiquant que la demande a réussi | Réponses du serveur |
| 301, Redirection 301 | Réponse du serveur indiquant qu’une page a déménagé définitivement et donnant sa nouvelle adresse | Changement d’adresse |
| 404 | Code de statut HTTP indiquant qu’aucune page n’a été trouvée à l’adresse demandée | Page introuvable |
alt, alternative textuelle | Texte qui transmet l’information d’une image aux personnes qui ne la voient pas. Une image décorative reçoit un alt vide | Images |
| Aperçu IA, Aperçus IA (AI Overview) | Réponse rédigée par IA dans Google, avec des liens vers des sources | Résultats Google |
| Backlink | Lien depuis un autre site vers le vôtre | Liens entre sites |
| Canonical | Indication de l’adresse de référence lorsque le même contenu existe à plusieurs URL | Le head |
| Certificat TLS | Certificat numérique qui permet au navigateur de vérifier l’identité du serveur lors de l’établissement d’une connexion HTTPS | HTTPS |
Chargement différé, loading="lazy" | Chargement d’une image reporté jusqu’à ce qu’elle approche de la zone visible. Il évite de télécharger immédiatement les images situées plus bas dans la page | Images sur mobile |
| CLS (Cumulative Layout Shift) | Score qui mesure les déplacements inattendus des éléments pendant la consultation d’une page | Stabilité visuelle |
| Code de statut HTTP | Nombre envoyé par le serveur pour indiquer le résultat d’une demande, par exemple 200, 301 ou 404 | Réponses du serveur |
| Conversion | Action que l’annonceur souhaite obtenir : réservation, inscription ou achat | Page d’arrivée |
| Core Web Vitals | Mesures de l’affichage (LCP), de la réactivité (INP) et de la stabilité visuelle (CLS) | Mobile |
| CPC, coût par clic | Coût par clic sur une annonce | Annonces Google |
| CSR, rendu côté client | Construction du contenu de la page par JavaScript dans le navigateur, après réception des fichiers du site | Rendu HTML |
| CTR, taux de clic | Taux de clic : clics divisés par impressions, exprimé en pourcentage | Search Console |
| DevTools | Outils de développement intégrés au navigateur pour inspecter une page, son code et son chargement | Inspection du HTML |
| Données structurées | Informations d’une page, comme le nom et l’adresse d’un lieu, décrites avec des champs standardisés pour les moteurs | JSON-LD |
| Enchère | Montant qu’un annonceur propose pour participer à l’attribution d’un emplacement publicitaire. Ce montant ne suffit pas à déterminer l’affichage | Annonces |
| Entraînement | Phase pendant laquelle un modèle d’IA apprend des régularités à partir de données. Elle est distincte d’une recherche web effectuée pour répondre à une question | Sources des IA |
| Exploration (crawling) | Visite et téléchargement de pages par un robot pour en lire le contenu. Une page explorée n’est pas forcément ajoutée à l’index | Moteurs |
| Fiche d’établissement Google | Fiche d’un lieu avec adresse, horaires, photos et avis | Visibilité locale |
| GEA | Publicité affichée avec les réponses d’une IA | Publicité |
| GEO | Travail sur un site pour qu’il puisse être cité dans les réponses des IA | GEO |
Google-Extended | Identifiant utilisé dans robots.txt pour contrôler certains usages des contenus par Gemini, sans modifier leur présence dans Google Search. Ce n’est pas un robot distinct | Usages des contenus |
| Googlebot | Robot qui explore les pages pour la recherche Google | Moteurs de recherche |
GPTBot | Robot d’OpenAI qui collecte des contenus pouvant servir à l’entraînement de ses modèles. Son autorisation se règle séparément de celle de la recherche dans ChatGPT | Robots OpenAI |
head | Partie du document HTML qui contient les informations sur la page, comme son titre et sa meta description | En-tête HTML |
| HTML | Langage de balisage qui structure une page web : titres, paragraphes, liens et images | Structure de la page |
| HTTP | Protocole, c’est-à-dire ensemble de règles, utilisé par le navigateur et le serveur pour échanger des pages et d’autres ressources web | Réponses du serveur |
| HTTPS | Version sécurisée de HTTP, qui chiffre les échanges entre le navigateur et le serveur | Connexion sécurisée |
| Impression, impressions | Affichage d’un résultat ou d’une annonce | Search Console |
| Index | Base dans laquelle un moteur de recherche conserve des informations sur les pages qu’il peut proposer dans ses résultats | Moteurs |
| Indexation | Analyse d’une page et ajout d’informations sur son contenu à l’index d’un moteur. Elle ne garantit pas une place dans les résultats | Moteurs |
| Injection de prompt | Instruction insérée dans un contenu pour tenter de détourner la réponse d’une IA qui le lit | Limites du GEO |
| INP (Interaction to Next Paint) | Indicateur du délai entre une interaction, comme un clic, et le prochain affichage de la page. Il sert à évaluer sa réactivité | Réactivité |
| Intention de recherche | Besoin derrière une recherche : comprendre, trouver, comparer ou réserver | Contenu |
| JSON-LD | Format de données structurées placé dans une balise script | Données structurées |
lastmod | Champ d’un sitemap qui indique la date de dernière modification du contenu d’une page | Sitemap |
| LCP (Largest Contentful Paint) | Temps nécessaire pour afficher le plus grand élément de contenu visible au chargement, souvent une image ou un bloc de texte | Chargement |
| Lighthouse | Outil d’audit qui teste une page et signale des problèmes de performance, d’accessibilité et de SEO. Son score ne mesure pas le classement dans Google | Audit |
llms.txt | Proposition de fichier Markdown qui présente un site et ses ressources aux outils d’IA. Il ne remplace pas robots.txt et ne garantit aucune citation | Limites du GEO |
| Longue traîne | Ensemble des recherches peu fréquentes, souvent précises | Mots des visiteurs |
| Meta description | Résumé de la page que Google peut reprendre comme extrait | Le head |
meta keywords | Ancienne balise destinée à lister des mots-clés sur une page. Google ne l’utilise pas pour classer les résultats | Idées reçues |
| Mode IA | Recherche Google sous forme de conversation, avec une réponse générée et des sources | Réponses d’IA |
noindex | Instruction demandant de ne pas indexer une page | Robots |
OAI-SearchBot | Robot d’OpenAI utilisé pour faire apparaître des sites dans les résultats de recherche de ChatGPT. Il a un rôle distinct de GPTBot | Robots OpenAI |
| Pack local | Bloc de résultats avec une carte et des fiches d’établissements | Résultats Google |
| Page d’arrivée (landing page) | Page ouverte après un clic sur une annonce | Publicité |
| Position moyenne | Dans Search Console, moyenne de la position du résultat le mieux placé du site pour chaque affichage pris en compte | Mesures |
| RAG | Méthode qui associe la recherche d’informations et la rédaction d’une réponse par IA | Sources des IA |
| Résultat enrichi, résultats enrichis | Résultat de recherche accompagné d’informations supplémentaires issues de données structurées, par exemple le temps de cuisson d’une recette. Cet affichage n’est pas garanti | Données structurées |
| Résultat naturel | Résultat qu’un moteur sélectionne et classe sans que le site paie pour cet emplacement | Résultats Google |
| Robot, crawler | Programme qui visite et télécharge des pages web | Moteurs de recherche |
robots.txt | Fichier qui indique aux robots quelles adresses ils peuvent explorer | Robots |
| SEA | Publicité dans les moteurs de recherche | Publicité |
| Search Console | Outil de Google pour suivre l’indexation, les recherches et les clics d’un site | Outils |
| SEO | Référencement naturel dans les moteurs de recherche | Présentation |
| SERP | Page de résultats d’un moteur de recherche | Résultats Google |
| Sitemap, sitemaps | Fichier XML qui liste les adresses des pages à faire découvrir | Sitemap |
| SSG, génération statique | Production des pages HTML lors de la construction du site. Ces fichiers sont ensuite envoyés aux visiteurs | Rendu HTML |
| SSR, rendu côté serveur | Production du HTML d’une page par le serveur en réponse à une demande, avant son envoi au navigateur | Rendu HTML |
title | Balise qui donne le titre de la page, visible notamment dans l’onglet du navigateur. Un moteur peut le reprendre dans ses résultats | Titre de page |
| Traceur publicitaire, traceurs publicitaires | Mécanisme, par exemple un cookie ou un pixel, utilisé pour suivre des visites ou des actions à des fins publicitaires | Mesure des conversions |
| URL | Adresse d’une ressource sur le web, comme une page, une image ou un fichier | Adresses |
viewport | Zone dans laquelle le navigateur affiche la page. La balise meta viewport permet notamment d’adapter sa largeur à celle du téléphone | Affichage mobile |
| XML | Format de texte qui organise des données avec des balises. Les sitemaps l’utilisent pour lister les adresses des pages | Sitemap |
Annexe : cheat-sheet SEO
Cette fiche rassemble les contrôles à faire avant de publier un site, puis pendant son suivi. Les exemples utilisent Prise d’Air, la salle d’escalade fictive du cours. Copiez ou imprimez cette fiche pour cocher les points applicables à votre projet.
Contenu et confiance
- Chaque page répond à une intention principale, par exemple connaître les tarifs ou préparer une première séance.
- Le sujet apparaît dans un
h1descriptif et la réponse commence dans les premières lignes. - Les
h2eth3organisent le contenu dans un ordre logique. - Le texte apporte des informations originales et vérifiées, sans répétition artificielle de mots-clés ni longueur imposée.
- L’établissement et les auteurs sont identifiables. Leur expérience, les sources et le contact sont précisés lorsque c’est utile.
- Les prix, horaires et conditions sont à jour. Les dates de mise à jour correspondent à de vraies modifications.
- Des liens internes permettent d’atteindre chaque page importante, avec un texte qui annonce la destination.
- Les liens entrants recherchés viennent de partenaires ou de publications pertinents, sans achat de liens destiné à manipuler le classement.
Revoir le chapitre sur le contenu.
HTML et métadonnées
- Chaque page possède un
titleunique, descriptif et concis, ainsi qu’une meta description adaptée à son contenu. - La langue et le
viewportsont déclarés. - Les zones de la page utilisent des balises adaptées, comme
nav,mainetfooter. - Les liens de navigation sont de vrais
<a href="…">, utilisables au clavier. - Le contenu à référencer est présent dans le HTML initial, produit en statique, SSG ou SSR, sans clic nécessaire pour le révéler.
- Si une URL canonique est indiquée, elle correspond au contenu de la page et reste cohérente avec les liens et le sitemap.
- Si le partage le justifie, Open Graph et les cartes X/Twitter proposent un aperçu avec une image publique.
- Si des données structurées sont pertinentes, le JSON-LD correspond au contenu visible et a été validé.
Exemple de head pour une page, à adapter avec le domaine réel :
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Séance découverte de bloc à Lyon | Prise d'Air</title>
  <meta name="description" content="Découvrez le bloc à Lyon 7e : séance de 1 h 30 à 18 €, chaussons compris. Consultez les conditions et réservez votre créneau.">
  <link rel="canonical" href="https://prisedair.example/seance-decouverte">
</head>
Google peut reformuler le titre et l’extrait. Le JSON-LD peut rendre une page éligible à certains résultats enrichis, sans garantir leur affichage ni une meilleure position.
Revoir le HTML, les aperçus de partage et le JSON-LD.
Exploration et indexation
- Les pages publiques à indexer répondent en HTTP
200et utilisent HTTPS. - Aucun
noindexde préproduction ne subsiste, y compris dans un éventuel en-tête HTTPX-Robots-Tag. -
robots.txtautorise l’exploration des pages et des ressources nécessaires à leur rendu. - Les URL sont lisibles et stables. Les doublons ont une adresse de référence cohérente.
- Un changement d’adresse utilise une redirection
301vers la page équivalente. Les liens internes ont été mis à jour. - Une page supprimée sans remplacement équivalent renvoie
404. - Si un sitemap est fourni, il liste les URL canoniques à indexer et reste accessible à l’adresse déclarée.
robots.txt contrôle l’exploration, noindex contrôle l’indexation. Pour lire un noindex, le robot doit pouvoir explorer la page. Aucun des deux ne protège les données privées : utilisez un contrôle d’accès.
Revoir les règles d’exploration.
Images, mobile et performance
- Le contenu reste lisible et utilisable sur téléphone, sans défilement horizontal de la page.
- Les images ont des noms descriptifs, un format et des dimensions adaptés à l’affichage.
- Chaque image informative possède un
altutile. Une image décorative reçoitalt="". - Les attributs
widthetheightréservent l’espace des images. -
loading="lazy"est réservé aux images hors écran au chargement, sans retarder l’image principale visible. - Le JavaScript, les scripts tiers, les polices et le CSS chargés sont limités aux besoins de la page.
- Le cache HTTP des fichiers statiques est configuré. Un CDN est envisagé si les mesures le justifient.
| Core Web Vital | Cible au 75e percentile |
|---|---|
| LCP : affichage principal | ≤ 2,5 s |
| INP : réponse aux interactions | ≤ 200 ms |
| CLS : stabilité visuelle | ≤ 0,1 |
Évaluez mobile et ordinateur séparément. Lighthouse aide au diagnostic, mais son test au chargement ne mesure pas l’INP réel des visiteurs. Utilisez les données de terrain lorsqu’elles sont disponibles. Une page rapide doit aussi répondre à la recherche. web.dev, mesures et seuils.
Après publication
- La propriété du site est validée dans Search Console.
- Le sitemap, s’il existe, est envoyé et son traitement est vérifié.
- Les URL importantes sont inspectées pour vérifier leur indexation et la canonique retenue par Google.
- Les problèmes d’indexation, de Core Web Vitals et de données structurées sont examinés dans les rapports disponibles.
- Les requêtes, impressions, clics et CTR sont comparés sur des périodes comparables. La position moyenne sert de repère, pas de classement fixe.
- Pour une activité locale, l’adresse, les horaires et les coordonnées concordent avec la fiche d’établissement.
Search Console aide à suivre le site, sans être une condition d’indexation. Un sitemap facilite la découverte, sans garantir que ses pages seront indexées. Google, démarrer avec Search Console.
Quel outil pour quel contrôle ?
| Contrôle | Outil ou méthode |
|---|---|
| Texte reçu avant JavaScript | Afficher le code source de la page |
Statut HTTP, redirection, cache, X-Robots-Tag | Onglet Réseau des DevTools |
| Mise en page et navigation | Affichage mobile et parcours au clavier |
| Problèmes techniques automatiques | Lighthouse dans Helium ou un autre navigateur compatible |
| Performance réelle d’un site publié | PageSpeed Insights et Search Console |
| Syntaxe et vocabulaire JSON-LD | Validateur schema.org |
| Éligibilité aux résultats enrichis pris en charge | Test de Google |
| Indexation et recherches qui apportent des visites | Search Console |
Pour l’atelier de correction, utilisez les contrôles de contenu, HTML, images et mobile. Les contrôles de domaine et de Search Console demandent un site réellement publié que vous gérez.